






数据采集怎么做网页解析?从页面结构到结构化输出的完整流程
多数采集项目卡在解析环节,不是卡在请求环节
请求拿到了HTTP 200,数据却没拿对——这是企业级数据采集项目里最常见的翻车场景。行业调研数据显示,在规模化采集任务中,约65%的数据质量问题出在解析阶段而非请求阶段。
原因很直接:同一个目标站点的页面结构会因为设备类型、登录状态、地域差异、A/B测试版本产生显著差异。一套固定的选择器写下去,上线第一周可能跑得很顺,第二周目标站稳微调了DOM结构,整条采集链路的输出就变成空值或脏数据。
技术团队容易陷入一个误区——把解析当成”写完选择器就完事”的一次性工作。实际上,网页解析是一套需要持续维护的工程链路。下面按执行顺序拆解5个关键环节。
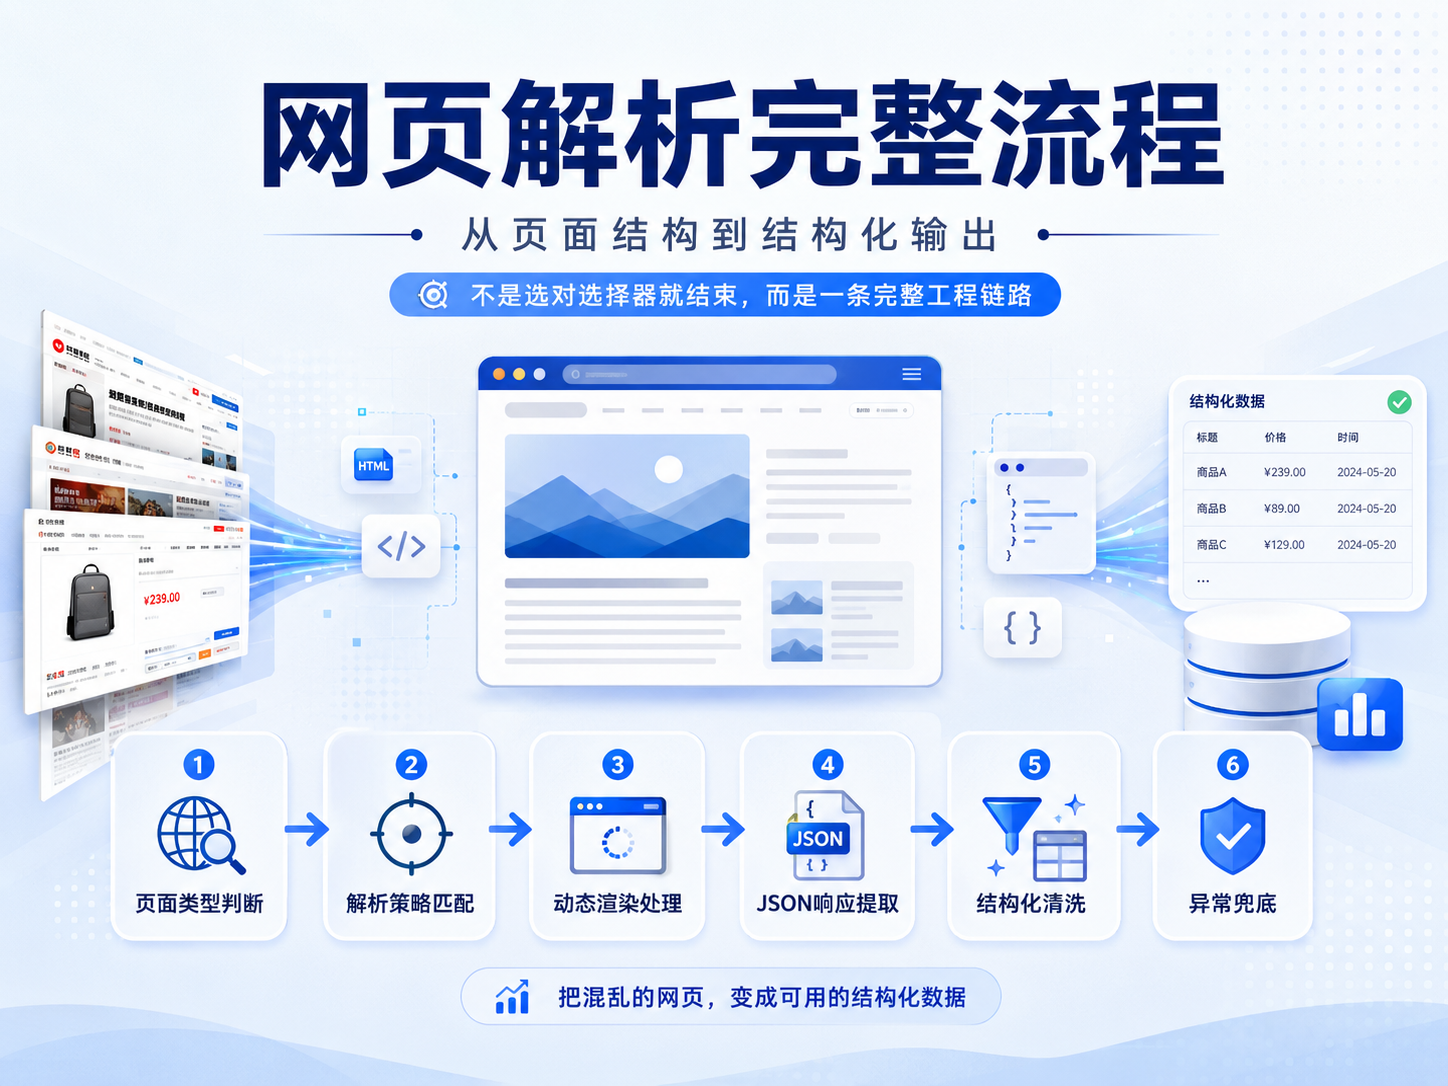
第一步:判断页面类型,决定解析策略
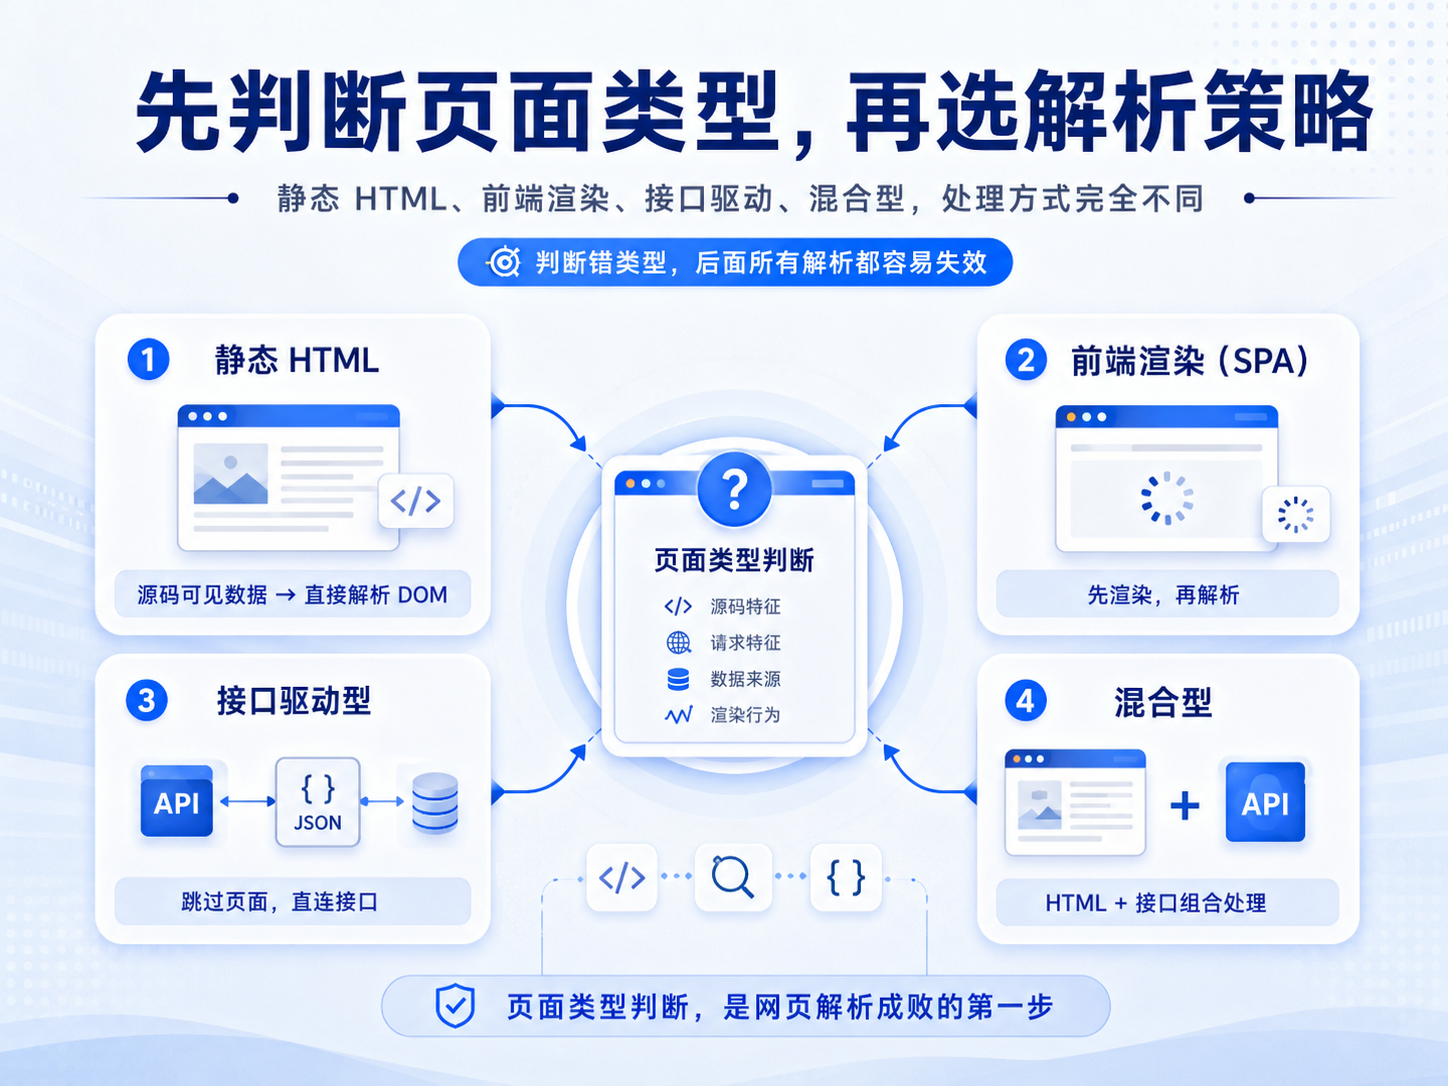
解析之前,先判断目标页面属于哪种渲染类型。判断错了,后面所有环节都是无效投入。
| 页面类型 | 识别特征 | 典型场景 | 解析策略方向 |
|---|---|---|---|
| 纯静态HTML | 右键”查看网页源代码”能看到完整数据内容 | 政府公告、招投标信息页、部分新闻站 | 直接解析HTML文档树 |
| 前端渲染(SPA) | 源代码只有<div id="app"></div>等空容器,数据靠JS动态填充 |
社交平台、电商商品详情页、数据看板 | 无头浏览器渲染后再解析,或直接拦截数据接口 |
| 接口驱动型 | 页面加载时通过XHR/Fetch请求JSON/XML接口获取数据 | 移动端H5页面、APP内嵌WebView、部分平台列表页 | 跳过页面,直接请求数据接口并解析响应体 |
| 混合型 | 部分数据在HTML中(如标题、SEO字段),部分数据靠JS加载(如评论、价格) | 电商平台、社交媒体帖子详情 | HTML解析+接口请求组合使用 |
判断方法:用curl或等效工具直接请求目标URL,对比返回的HTML源码与浏览器渲染后的DOM。如果源码里已经包含目标数据字段,属于静态页面;如果源码空壳而浏览器里有数据,说明是前端渲染或接口驱动型。
在舆情监测场景中,采集对象通常覆盖新闻站、社交平台、论坛三类站点,页面类型混杂是常态。第三方测试表明,跨类型站点的采集项目如果不做预判直接套同一种解析方案,数据缺失率可能达到30%-40%。
第二步:静态HTML页面的解析流程
静态页面是解析难度最低的类型,但”难度低”不等于”不会出问题”。
核心流程:
- 获取HTML文档 → 发送HTTP请求拿到原始HTML文本
- 构建文档树 → 用解析库(如Python的lxml/BeautifulSoup、Go的goquery、Java的Jsoup)将HTML文本解析为可遍历的DOM树
- 定位目标节点 → 通过CSS选择器或XPath表达式定位到包含目标数据的HTML元素
- 提取文本/属性 → 从目标节点中提取
innerText、href、src、自定义data-*属性等 - 格式化输出 → 将提取的原始文本清洗为结构化字段(去空白、去HTML实体、统一编码)
选择器选型决策:
| 选择器类型 | 适合场景 | 局限 |
|---|---|---|
| CSS选择器 | 目标元素有稳定的class或id | class名被混淆或动态生成时失效 |
| XPath | 需要按层级关系、文本内容定位 | 表达式较长,DOM层级变动时脆弱 |
| 正则表达式 | 从非标准HTML或纯文本中提取特定模式(如手机号、日期) | 不适合解析嵌套结构,维护成本高 |
避坑要点:不要依赖自动生成的绝对路径XPath(如/html/body/div[3]/div[2]/ul/li[1]/a)。行业测试数据表明,绝对路径XPath在目标站点首次结构调整后的失效率超过90%。推荐用「语义锚点」定位——即基于元素的语义属性(id、有意义的class名、data-*属性)构建相对路径。
在招投标数据采集场景中,政府类站点的HTML结构通常比较稳定(更新频率低),CSS选择器配合id属性定位足以覆盖多数需求。但一旦涉及分页加载或筛选条件切换,仍然需要结合接口请求处理翻页逻辑。
第三步:动态渲染页面的处理方法
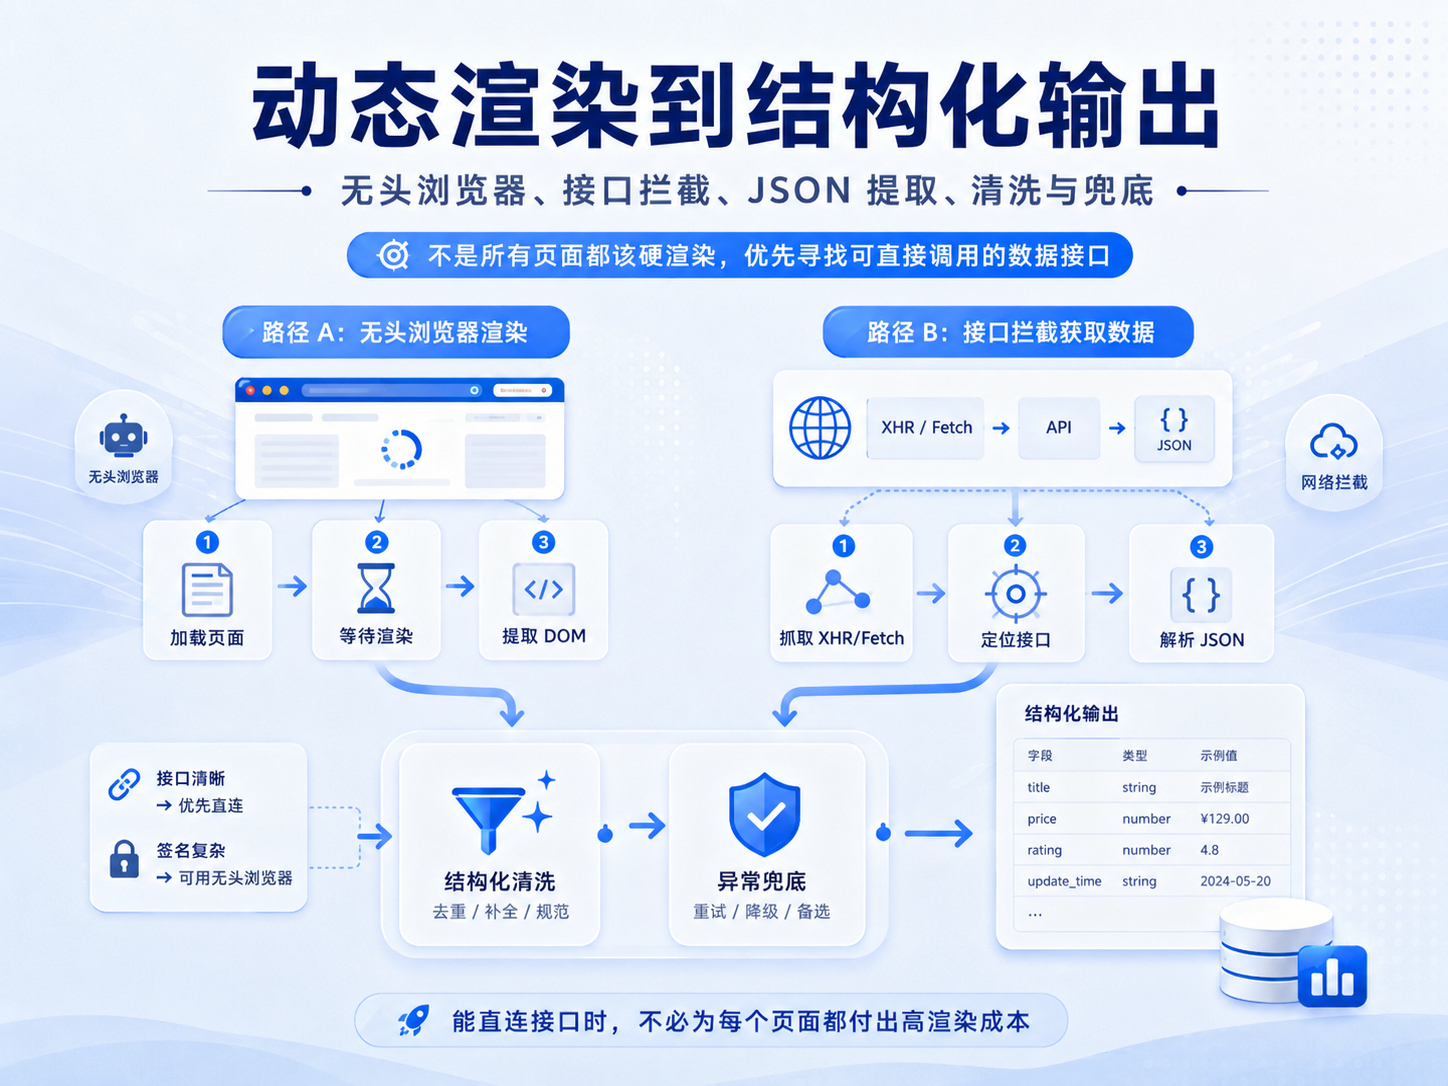
当curl返回的HTML不包含目标数据,说明页面依赖JavaScript执行后才填充内容。这类页面有两种主流处理路径:
路径A:无头浏览器渲染后解析
用Puppeteer(Node.js)、Playwright(多语言支持)、Selenium(传统方案)等工具启动无头浏览器,等待页面渲染完成后再抓取DOM。
关键步骤:
- 启动无头浏览器实例,加载目标URL
- 等待目标数据元素出现(用
waitForSelector或自定义等待条件,不要用固定的sleep) - 获取渲染后的完整HTML
- 对渲染后的HTML执行静态解析流程(同第二步)
无头浏览器方案的成本:公开性能测试数据显示,单个无头浏览器实例的内存占用通常在150MB-300MB之间,启动到首次渲染完成的耗时在2-5秒。在网站采集器场景中,如果目标站点有1000个列表页需要采集,全部走无头浏览器意味着采集周期和资源成本会比纯HTTP请求方案高出5-10倍。
路径B:拦截数据接口直接请求
多数前端渲染页面的数据来源是后端API接口。通过浏览器开发者工具(Network面板)抓取页面加载过程中的XHR/Fetch请求,找到返回目标数据的接口URL和参数结构。
操作步骤:
- 打开浏览器开发者工具 → Network → 筛选XHR/Fetch
- 刷新页面,观察哪些请求的Response包含目标数据
- 记录接口URL、请求方法(GET/POST)、请求头(特别是
Authorization、Cookie、自定义签名参数)、请求体 - 用HTTP客户端直接请求该接口,验证返回数据完整性
- 若接口有签名校验或Token机制,需要逆向分析生成逻辑或通过会话管理获取有效凭证
选哪条路径?
| 判断条件 | 推荐路径 |
|---|---|
| 目标站点API接口清晰,参数透明,无复杂签名 | 路径B(接口直请求),效率高10倍+ |
| 接口有复杂签名/加密,逆向成本高 | 路径A(无头浏览器),牺牲效率换稳定性 |
| 页面有无限滚动、懒加载、用户交互触发的内容 | 路径A,需模拟滚动/点击行为 |
| 采集频次低(天级别/周级别)、页面数少 | 路径A,开发成本低,无需逆向 |
| 采集频次高(小时级/分钟级)、页面数多 | 路径B是首选,无头浏览器资源消耗不可控 |
在APP大数据分析场景中,移动端页面几乎全部是接口驱动型——APP内的数据请求直接走API,路径B的投入产出比显著更高。
第四步:API/JSON响应数据的结构化提取
无论是直接请求数据接口还是从无头浏览器中拦截响应,拿到的数据通常是JSON格式。JSON解析看起来简单,但在规模化场景中有几个容易踩坑的点。
嵌套结构的遍历策略:
# 典型的API响应结构示例
{
  "code": 200,
  "data": {
    "list": [
      {
        "title": "...",
        "content": "...",
        "meta": {
          "author": "...",
          "publish_time": "2026-06-10T08:30:00Z"
        }
      }
    ],
    "pagination": {
      "total": 1500,
      "page_size": 20,
      "current_page": 1
    }
  }
}
提取目标字段时,按data.list[].title、data.list[].meta.publish_time这种路径表达式取值。关键是不要硬编码数组索引——接口返回的列表顺序可能变化,按索引取值会导致数据错位。
常见异常及应对:
| 异常类型 | 表现 | 应对措施 |
|---|---|---|
| 字段缺失 | 部分记录缺少某个字段(如meta.author为null) |
取值前做空值检查,缺失字段填默认值或标记为待补 |
| 类型不一致 | 同一字段在不同记录中类型不同(数组/字符串/数字交替出现) | 统一做类型强转,转换失败记录到异常日志 |
| 分页参数变化 | 翻页到中间某页时接口返回格式变化或总数发生波动 | 翻页请求间隔不要太短,每页数据落库后做数量校验 |
| 编码问题 | 中文字段出现\u转义或乱码 |
确认响应头的Content-Type编码声明,必要时手动指定解码方式 |
第三方测试表明,在日均请求量超过10万次的采集任务中,JSON响应中字段缺失的平均概率约为3%-8%。如果不做空值防御直接写入数据库,后续的数据清洗成本会成倍增加。
第五步:解析结果的清洗与异常兜底
原始解析输出不等于可用数据。从HTML提取的文本通常包含多余空白符、不可见字符、HTML实体编码(如&、 )、行内样式标签残留等噪声。
清洗流程:
- 去除HTML标签残留 → 对
innerText提取后仍残留的<span>、<br>等标签做二次清理 - 规范化空白 → 连续空格/换行压缩为单个空格,首尾空白去除
- HTML实体解码 →
&→&,<→<,'→' - 编码统一 → 全部转为UTF-8
- 格式校验 → 日期字段统一为ISO 8601格式,数值字段去除货币符号/千分位后转数字类型,URL字段校验协议头
- 去重 → 基于业务主键(如文章URL+发布时间)去除重复记录
异常兜底机制:
解析失败不应该让整条采集任务中断。推荐的兜底策略是:
- 单条记录解析失败 → 记录异常日志(含原始HTML/JSON片段+失败原因),跳过该条,继续处理后续记录
- 整页解析失败(如目标站点改版导致选择器全部失效) → 触发告警,暂停该站点的采集任务,保留原始响应用于后续人工排查
- 连续N页解析失败 → 判定为站点结构变更,自动降级为”仅存原始数据”模式,等待解析规则更新
在舆情监测场景中,一次采集任务可能覆盖数百个站点。行业实践数据表明,在100+站点的并行采集中,每周至少有5%-10%的站点会发生结构微调。如果没有异常兜底机制,这些站点的数据中断会在下游的分析环节产生连锁影响。
解析策略与页面类型的速查决策表
| 判断维度 | 静态HTML | 前端渲染(SPA) | 接口驱动型 | 混合型 |
|---|---|---|---|---|
| 解析方式 | CSS选择器/XPath | 无头浏览器+CSS选择器 或 拦截接口 | 直接请求接口+JSON解析 | HTML解析+接口请求组合 |
| 开发成本 | 低 | 中-高 | 中(需分析接口) | 高(两套逻辑) |
| 运行成本 | 低(纯HTTP请求) | 高(浏览器资源占用) | 低(纯HTTP请求) | 中 |
| 维护成本 | 中(DOM变更需更新选择器) | 高(浏览器版本+DOM双重维护) | 低(接口格式相对稳定) | 高(两套维护) |
| 适合采集频次 | 分钟级-天级 | 天级-周级(资源受限) | 分钟级-秒级 | 小时级-天级 |
| 典型锚点场景 | 招投标数据、政务公告 | 社交平台、电商详情页 | APP数据分析、移动端H5 | 电商列表页、新闻聚合站 |
做解析策略选型时,优先考虑路径B(直接请求接口)——即使目标页面看起来是前端渲染型,也值得先花时间在Network面板里找找有没有可用的数据接口。行业经验表明,约70%的前端渲染页面背后都存在可直接调用的JSON接口,只是没有被文档化。
决定解析策略之后,给每个采集目标建一份「解析规则卡片」,记录页面类型、解析方式、关键选择器/接口URL、最后验证时间、异常兜底级别。规则卡片是后续维护的唯一锚点——当站点结构变更时,排查和修复都从卡片入手,不需要从头逆向整个页面。
FAQ
Q1:网页解析和网页抓取有什么区别?
A:抓取(crawling/scraping)是获取网页原始内容的过程,解析(parsing)是从原始内容中提取结构化数据的过程。抓取解决的是”怎么拿到页面”,解析解决的是”怎么从页面里提取有用的字段”。一个完整的数据采集链路 = 请求管理 + 网页解析 + 数据清洗 + 存储入库。
Q2:解析库选BeautifulSoup还是lxml?
A:lxml在解析速度上比BeautifulSoup快5-10倍(基于C语言实现),适合大规模采集任务。BeautifulSoup的容错性更强,对格式混乱的HTML处理能力更好,适合目标站点HTML质量参差不齐的场景。两者可以组合使用——BeautifulSoup底层指定lxml作为解析器,兼顾速度和容错。
Q3:无头浏览器方案会不会被目标站点的访问频率控制机制识别?
A:无头浏览器的请求特征(如User-Agent、navigator.webdriver属性、Canvas指纹等)确实比纯HTTP请求更容易被检测到。建议配置完整的浏览器指纹(包括UA、分辨率、语言、时区),设置合理的请求间隔,并通过代理IP轮换降低单IP访问频次集中度。
Q4:JSON接口的签名参数逆向难度大,有没有替代方案?
A:三种替代思路。第一,直接用无头浏览器加载页面,在浏览器环境内执行JS生成签名——不需要逆向,但运行成本高。第二,检查移动端接口——APP端接口的签名机制有时比Web端简单。第三,观察签名参数的变化规律——部分签名只依赖时间戳和固定密钥,可以通过多次请求对比推断生成逻辑。
Q5:采集任务上线后,怎么监控解析规则是否还有效?
A:设置3层监控。第一层:每次采集任务完成后统计「有效数据条数/总请求数」,比值低于预设阈值(如80%)触发告警。第二层:对关键字段做非空率校验,任一字段非空率骤降说明对应的选择器可能失效。第三层:每周对采集样本做人工抽检(抽检率5%-10%),核对数据准确性。
Q6:同一个站点不同页面结构差异大怎么处理?
A:建立「页面模板库」——把同一站点的页面按结构特征分组(如列表页模板、详情页模板、搜索结果页模板),每组配一套独立的解析规则。采集时先识别当前页面属于哪个模板(通过URL路径模式、页面特征元素判断),再调用对应的解析规则。行业实践中,一个中大型站点通常需要3-8套页面模板才能覆盖主要页面类型。