















深入解析:HTTP 代理的工作原理
本文讲 HTTP 代理的工作原理,真正卡住企业级采集的,常不是”用没用 HTTP 代理”,而是搞错了它在协议栈的哪一层、能改写什么、改不了什么。我们青果网络长期服务网站采集器、广告监测这类基于 HTTP/HTTPS 协议的大规模采集业务,把”协议层可控性 + 后端池机制”作为评估 HTTP 代理的真正判断轴——下文就沿这条轴展开。
把 HTTP 代理理解成”HTTP 版的转发器”,是协议选型出错的起点
多数技术决策者对 HTTP 代理的理解停在一句话:”用 HTTP 协议帮我转发请求的代理”。选型时只把 HTTP 代理和 SOCKS5 代理放在一起比”哪个更通用”,默认两者只是协议不同、能力等价。
这套理解在协议层就埋了误判。它至少漏掉了三件事:
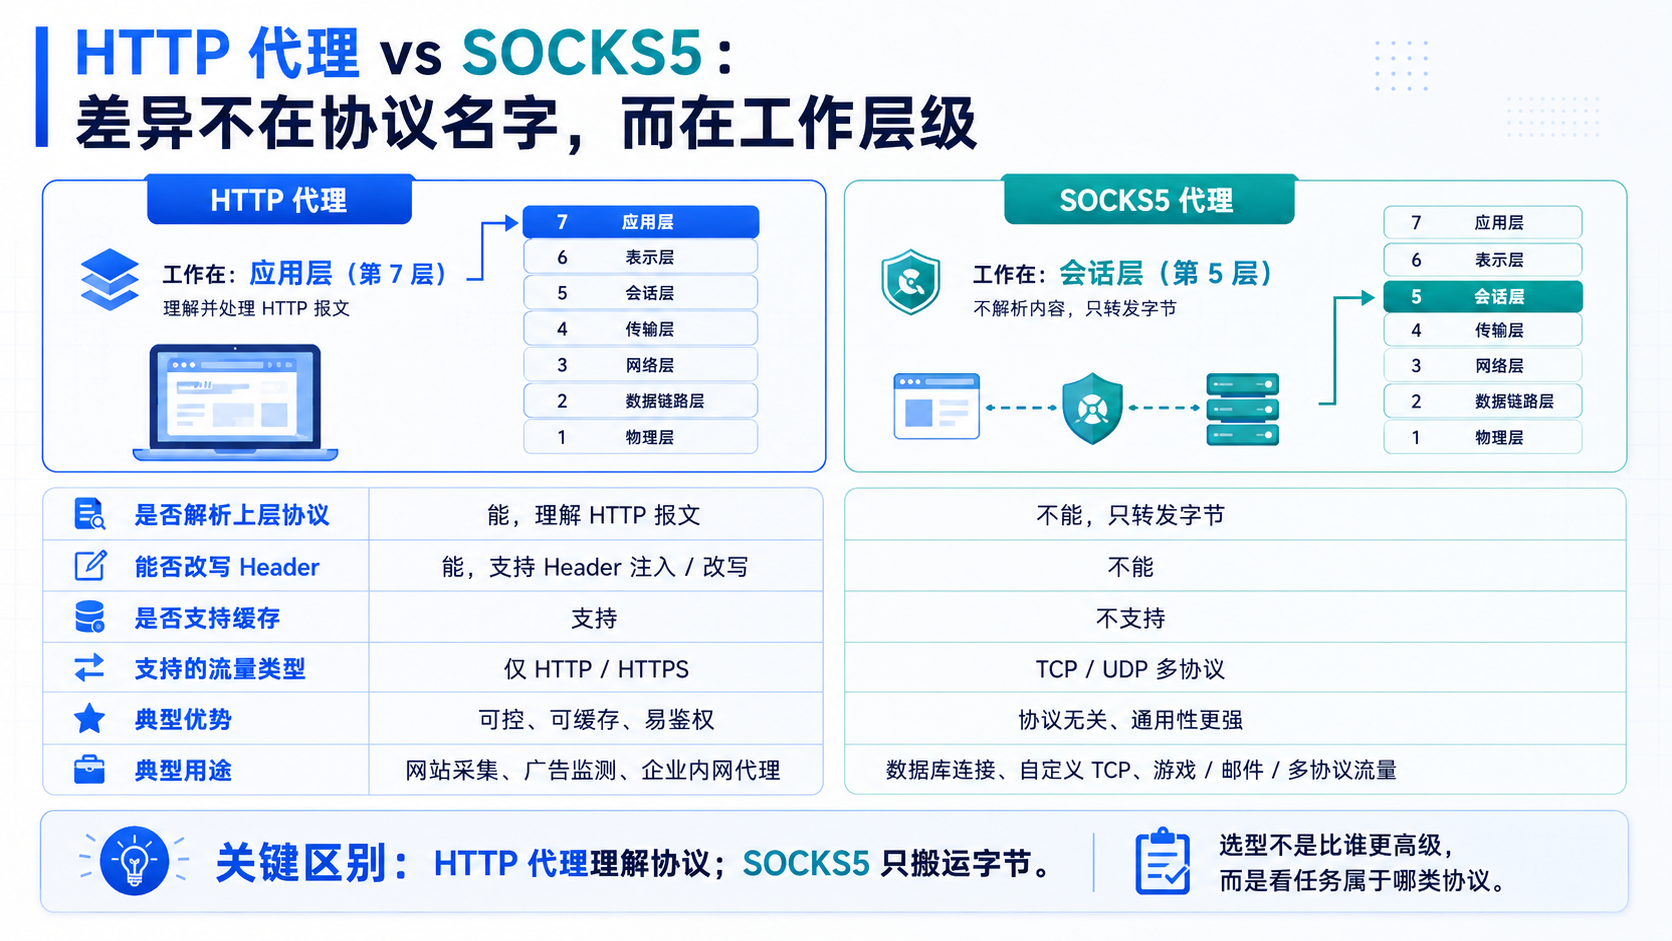
第一,HTTP 代理工作在 OSI 第七层(应用层),它能读懂并改写 HTTP 报文;SOCKS5 工作在第五层(会话层),只搬运字节、不理解上层协议。这不是”哪个更高级”的问题,而是”能不能在协议层做精细控制”的问题。
第二,HTTP 代理处理 HTTPS 时走的不是普通的转发,而是一条叫 CONNECT 的隧道——这一步常被忽略,但它直接决定了 HTTPS 流量在代理上能做什么、不能做什么。
第三,HTTP 代理对非 HTTP 协议(数据库连接、邮件协议、自定义 TCP)是无能为力的——这是它的硬边界,不是配置问题。
所以问题不是”HTTP 代理够不够通用”,而是”它工作在哪一层、能改什么报文、对哪些流量无效”。 把视角从协议名字挪到协议层行为,才是看懂 HTTP 代理原理的起点。
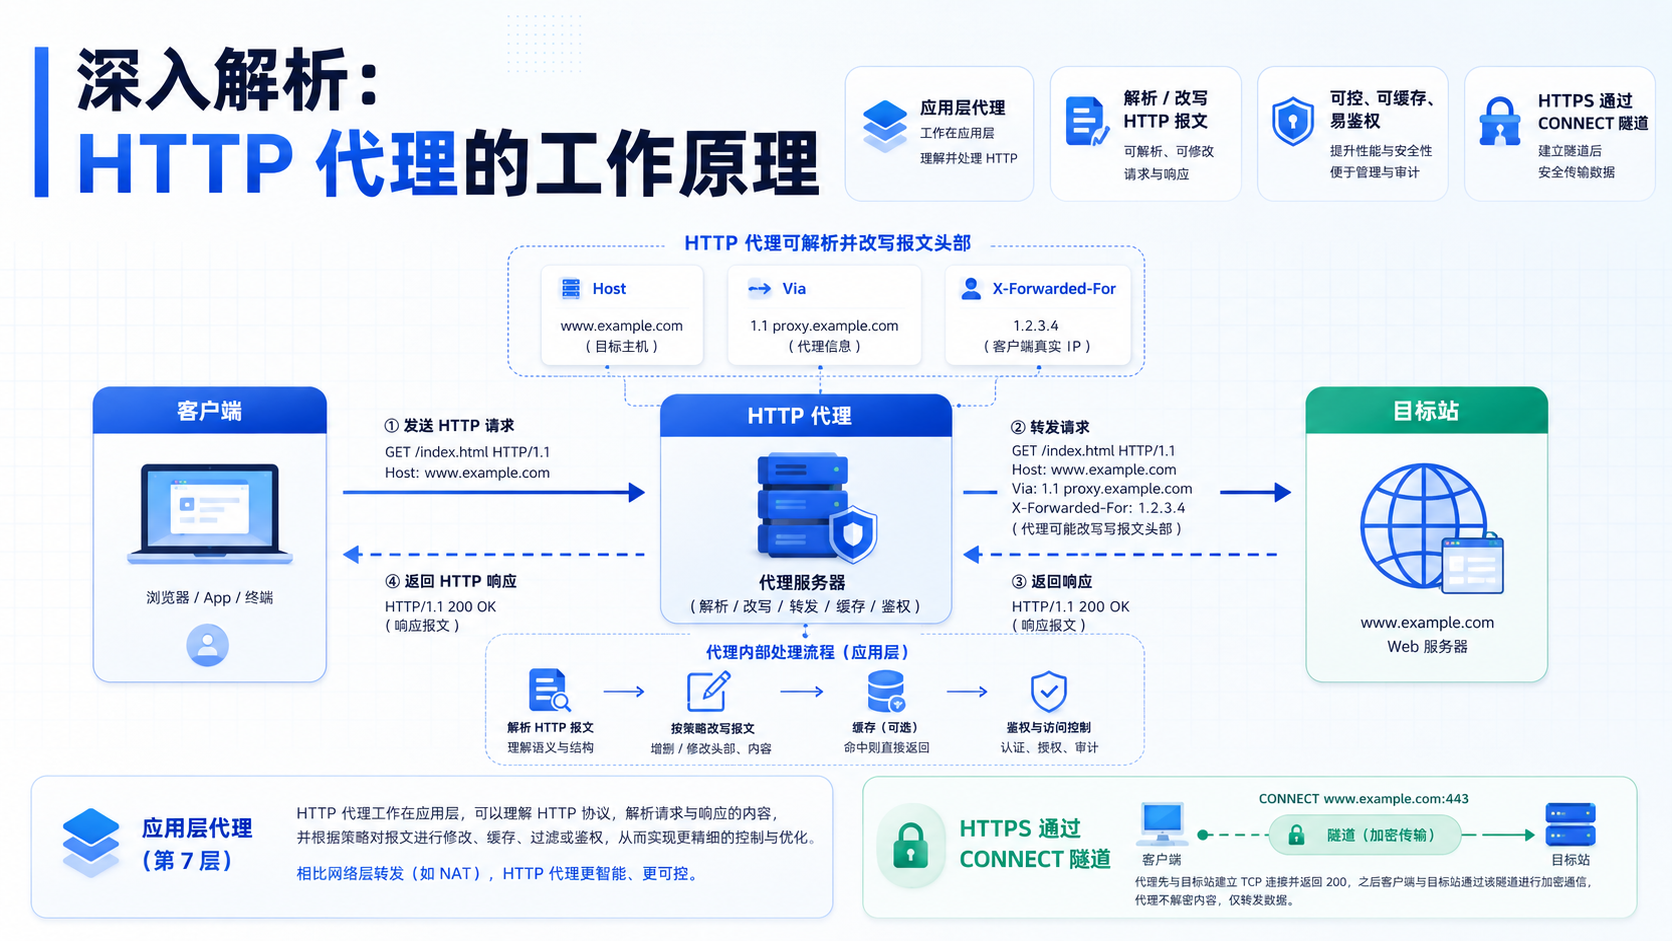
一次 HTTP 代理请求真正经过的环节:报文改写才是它和 SOCKS5 的分界
一次 HTTP 代理请求的本质,是客户端把请求发给代理、代理解析报文后再发给目标站,响应原路返回。但这段叙述里隐藏了一个关键差异:代理在中间读懂并改写了 HTTP 报文,而不只是搬运字节。
把这条链路拆开看,真正产生差异的是”代理理解协议”这一步:
| 环节 | 在做什么 | HTTP 代理特有的能力 |
|---|---|---|
| 客户端发起请求 | 构造 HTTP 报文,指向代理地址 | 否 |
| 代理接收并解析报文 | 读取请求行、Header、Body | 是(SOCKS5 不做这步) |
| 代理改写 / 注入 Header | 改 Host、Via、X-Forwarded-For,做鉴权校验 | 是 |
| 代理转发至目标站 | 以代理出口 IP 发送改写后的请求 | 否(执行) |
| 接收响应,可选缓存 | 拿到响应可按规则缓存(HTTP 语义支持) | 是(SOCKS5 不做这步) |
| 响应回传客户端 | 按 HTTP 报文格式回写 | 否(执行) |
差异全部集中在”代理理解协议”那两步。能解析报文,意味着代理可以做账密鉴权、Header 注入、URL 级访问控制、缓存复用——这些都是协议层能力。SOCKS5 只搬字节,做不了这些精细控制,但它换来的是协议无关:任何基于 TCP/UDP 的流量都能走。
这个差异不是抽象的协议术语,而是直接影响企业级采集选型的——网站采集器要做大规模 HTTP/HTTPS 抓取、需要按 Header 注入做请求标识,HTTP 代理的协议层能力是它的优势;如果要走自定义 TCP 协议的采集任务,HTTP 代理就完全派不上用场,必须换 SOCKS5。
补充一句:HTTP 代理和 SOCKS5 在企业级场景里不是二选一。我们的产品线全协议支持 HTTP(S)/SOCKS5,按任务的协议特征对应,而不是按”哪个协议听起来更通用”做选择。
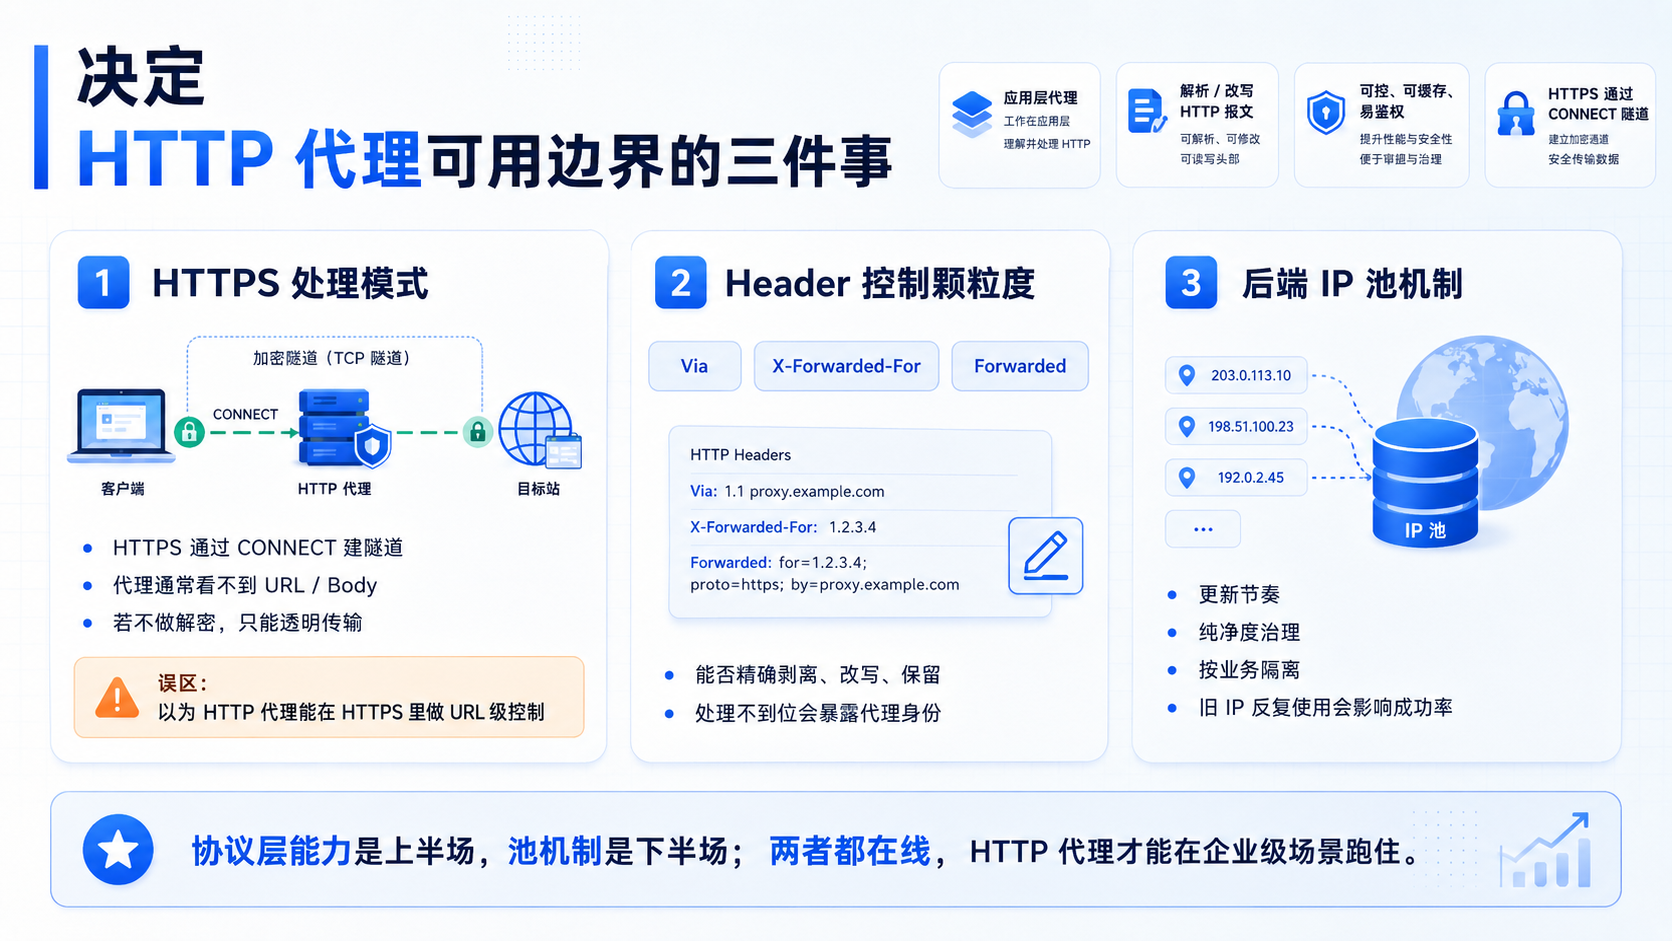
决定 HTTP 代理可用边界的三件事:HTTPS 处理、Header 控制、池机制
同样叫”HTTP 代理”,企业级场景能不能用,落在三件用户看不见的事上:HTTPS 走的什么模式、Header 改写的颗粒度、背后的 IP 池怎么治理。前两件是协议层的,后一件穿透到后端池。
| 机制 | 在控制什么 | 治理不到位的后果 |
|---|---|---|
| HTTPS 处理模式 | HTTPS 走 CONNECT 隧道,代理只看到加密字节,看不到 URL/Body | 误以为 HTTP 代理能在 HTTPS 流量里做 URL 级控制,实际做不到 |
| Header 控制颗粒度 | 能否精确改写 Via、X-Forwarded-For 等暴露代理身份的 Header | 改写不彻底,目标站从 Header 识别出代理身份,采集成功率压不上去 |
| 后端 IP 池机制 | 池的更新节奏、纯净度治理、能否按业务隔离 | 协议层做得再好,旧 IP 反复用、池被污染,采集照样限制 |
第一件是 HTTPS 处理模式。 这里要先讲清楚:HTTPS 流量经过 HTTP 代理时,客户端先向代理发一个 CONNECT 请求,代理与目标站建立 TCP 隧道,之后所有 HTTPS 加密数据在这条隧道里透明传输——代理看不到 URL、看不到 Body,只搬运加密字节。这一步常被理解错。它的实际含义是:HTTPS 流量上,HTTP 代理的”协议层精细控制”能力基本失效,退化成一个 TCP 隧道。要在 HTTPS 上做 URL 级控制,必须做中间人解密,而这在企业级合规采集场景里通常不被允许。
第二件是 Header 控制颗粒度。 HTTP 代理默认会注入 Via、X-Forwarded-For 等 Header,这些 Header 等于在响应里”自报家门”。一个治理到位的 HTTP 代理服务会把这些 Header 的处理规则做透——该剥的剥、该改的改、该保留的保留。这个颗粒度直接影响请求在目标站看来”像不像一个正常请求”,也直接影响访问环境隔离性。
第三件是后端 IP 池机制。 协议层做得再好,后端池本身是垃圾的也跑不动。我们日更 600 万+ 纯净 IP、全球 2000 万+ 纯净 IP 资源,覆盖 200+ 城市与 200+ 国家,底子是三大运营商节点;池里的 IP 在进池前都做过访问频率控制黑名单清洗——这就是我们把 IP 称作”纯净 IP”的原因。HTTP 代理的协议层能力是上半场,池机制是下半场,两者都要在线才有 99.9% 可用率与 <100ms 平均延迟。
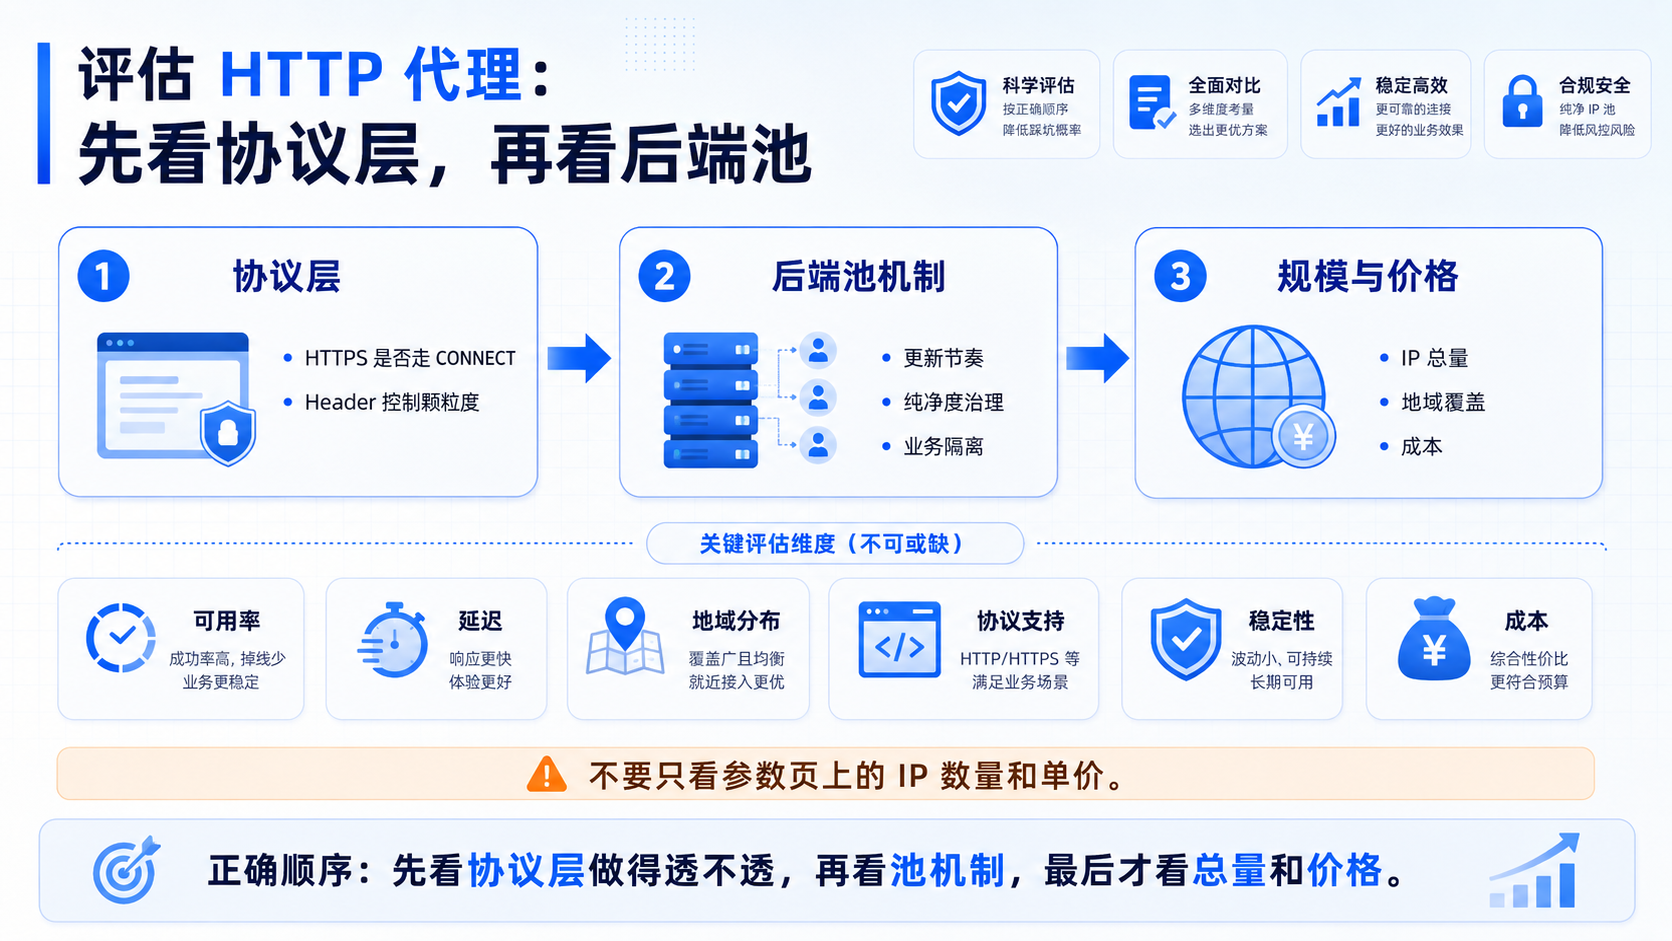
把这三件事连起来,就是我们(青果网络)在企业级 HTTP 代理服务中沉淀的评估顺序:先看协议层做得透不透(HTTPS 模式、Header 颗粒度),再看后端池机制(更新节奏、纯净度、业务隔离),最后才看 IP 总量和价格。 顺序反过来,就被参数页带偏。
评估 HTTP 代理,先看协议层做得透不透,再看后端池
回到最初的问题:HTTP 代理不是”HTTP 协议的转发器”,而是工作在应用层的、能解析并改写 HTTP 报文的中间节点。看懂它的原理,等于把评估顺序摆正——先看协议层做得透不透(HTTPS 处理模式、Header 控制颗粒度),再看后端池机制(更新节奏、纯净度、业务隔离),最后才看总量和价格。
青果网络在长期服务网站采集器、广告监测这类基于 HTTP/HTTPS 的大规模采集业务时的判断是:决定一套 HTTP 代理能不能在企业级跑住的,是协议层对 Header 与 HTTPS 隧道的处理颗粒度、再叠加后端纯净 IP 池的业务级隔离能力——这两条不写在参数页,却直接定义采集成功率的下限。评估期可以用 青果网络的6 小时免费测试在自己的真实任务上跑一遍,而不是只看协议名字与单价做判断。
协议名字回答的是”你用什么搬运”,协议层行为和池机制回答的是”搬得动不动、搬完之后还能不能继续搬”。企业级 HTTP 代理选型,赌的从来是后者。
FAQ 常见问题解答
Q1: HTTP 代理和 SOCKS5 代理在工作原理上到底差在哪?
A: 差在协议栈的层级,以及由此带来的能力不同。HTTP 代理工作在第七层(应用层),会解析 HTTP 报文,能做 Header 改写、账密鉴权、缓存复用这类精细控制,但它只处理 HTTP/HTTPS 流量。SOCKS5 工作在第五层(会话层),只搬运 TCP/UDP 字节、不理解上层协议——失去了协议层精细控制,但换来了协议无关:数据库连接、邮件协议等非 HTTP 流量都能走。选型不是比谁更通用,而是按任务的协议特征对应。
Q2: HTTP 代理处理 HTTPS 时是怎么工作的?为什么说它”看不到”加密内容?
A: HTTPS 流量经过 HTTP 代理时,客户端先发一个 CONNECT 请求,代理与目标站建立一条 TCP 隧道,之后所有加密数据在这条隧道里透明传输——代理只看得到加密字节,看不到 URL 和 Body。这就是为什么 HTTP 代理在 HTTPS 流量上的”协议层精细控制”基本失效,退化成一条 TCP 隧道。想在 HTTPS 上做 URL 级控制要走中间人解密,在企业级合规采集场景通常不被允许。
Q3: 我用 HTTP 代理做采集,为什么有时候请求会被目标站直接识别出”是代理”?
A: 多半出在 Header 这一层。HTTP 代理默认会注入 Via、X-Forwarded-For 等 Header,如果代理服务对这些 Header 的处理颗粒度不够,请求一发出去就在响应链路上”自报家门”。我们(青果网络)在网站采集器场景的实践中观察到,排查这类问题要从两条线一起看:一是代理对暴露代理身份的 Header 是否做了彻底处理,二是出口 IP 是否在进池前做过纯净度清洗——这两条任何一条不到位,目标站都能识别。
Q4: HTTP 代理和”透明代理 / 匿名代理 / 高匿代理”是什么关系?
A: 后面三个不是另一类代理,而是按 Header 处理颗粒度做的分级:透明代理保留所有暴露代理身份的 Header;一般匿名代理剥掉一部分但仍能看出代理痕迹;请求环境隔离性更好的代理则把 Header 处理得更彻底。它们都可以是 HTTP 代理,只是协议层的 Header 处理策略不同。企业级采集通常要求做到最彻底的那一级,以保证请求在目标站看来与正常请求差异最小。
Q5: HTTP 代理可以做缓存,这个能力在企业级采集里有用吗?
A: HTTP 代理读得懂 HTTP 报文,理论上可以按 Cache-Control 等 Header 做响应缓存,这是它相对 SOCKS5 的一个协议层能力。但在企业级大规模采集场景下,缓存通常不被默认启用——采集要的是实时数据,缓存反而会让结果失真。缓存能力在企业内网代理(给员工访问外网用)里价值更大,在采集类用途里更多是”知道有这个能力,但默认关掉”。
Q6: 评估一个 HTTP 代理服务,应该看哪几个维度才不容易踩坑?
A: 建议按”先协议层、后池机制、最后看规模”的顺序看六个维度:可用率、延迟、地域分布、协议支持、稳定性、成本。其中协议支持要细问到 HTTPS 是不是走 CONNECT、Header 处理颗粒度如何;可用率和稳定性反映后端池的更新节奏与纯净度治理;地域分布反映资源覆盖。把这六项放在一起看,比单独盯 IP 总量或单价都更接近真实可用性。用自己的真实采集任务在评估期跑一段,会比看参数表可靠得多。


