












可用率99.9%的数据采集是什么体验——从一次企业级代理IP实践说起
本篇拆的是网站采集器场景下,采集可用率从”够用”到”可承诺”的工程路径。我们青果网络长期服务网站采集器、舆情监测这类高并发持续采集业务,在实际项目中反复验证过一个判断:客户把可用率从76%推到99.9%,卡点几乎都不在IP池大小,而在后端池更新节奏与业务隔离粒度是否匹配采集任务的实际节奏。下文从一个真实项目出发,把这20%+拆成可复制的三个工程节点。
IP池够大了,为什么采集还是第三天开始崩
大多数技术团队遇到采集可用率下降,第一反应是”IP不够”。这个判断在轻量级采集里大致成立,但企业级场景下往往是错的。
我们青果网络在服务网站采集器客户的过程中(来源:青果实践观测,2024–2025,样本=数十个企业级项目),归纳出一个反复出现的故障模式:采集任务前3天一切正常,可用率稳定在76%以上;第4天开始间歇性下滑,某些目标站点的采集成功率骤降到96%甚至更低。客户加了IP,没变化;换了IP提取方式,也没变化。
这种”先稳后崩”的模式,根因通常不在IP数量,而在三个容易被忽略的工程节点:后端池更新节奏与采集高峰的错位、故障IP切换时延过长、多个采集任务共用同一IP池导致的交叉污染。下文把这三个节点逐一拆开。
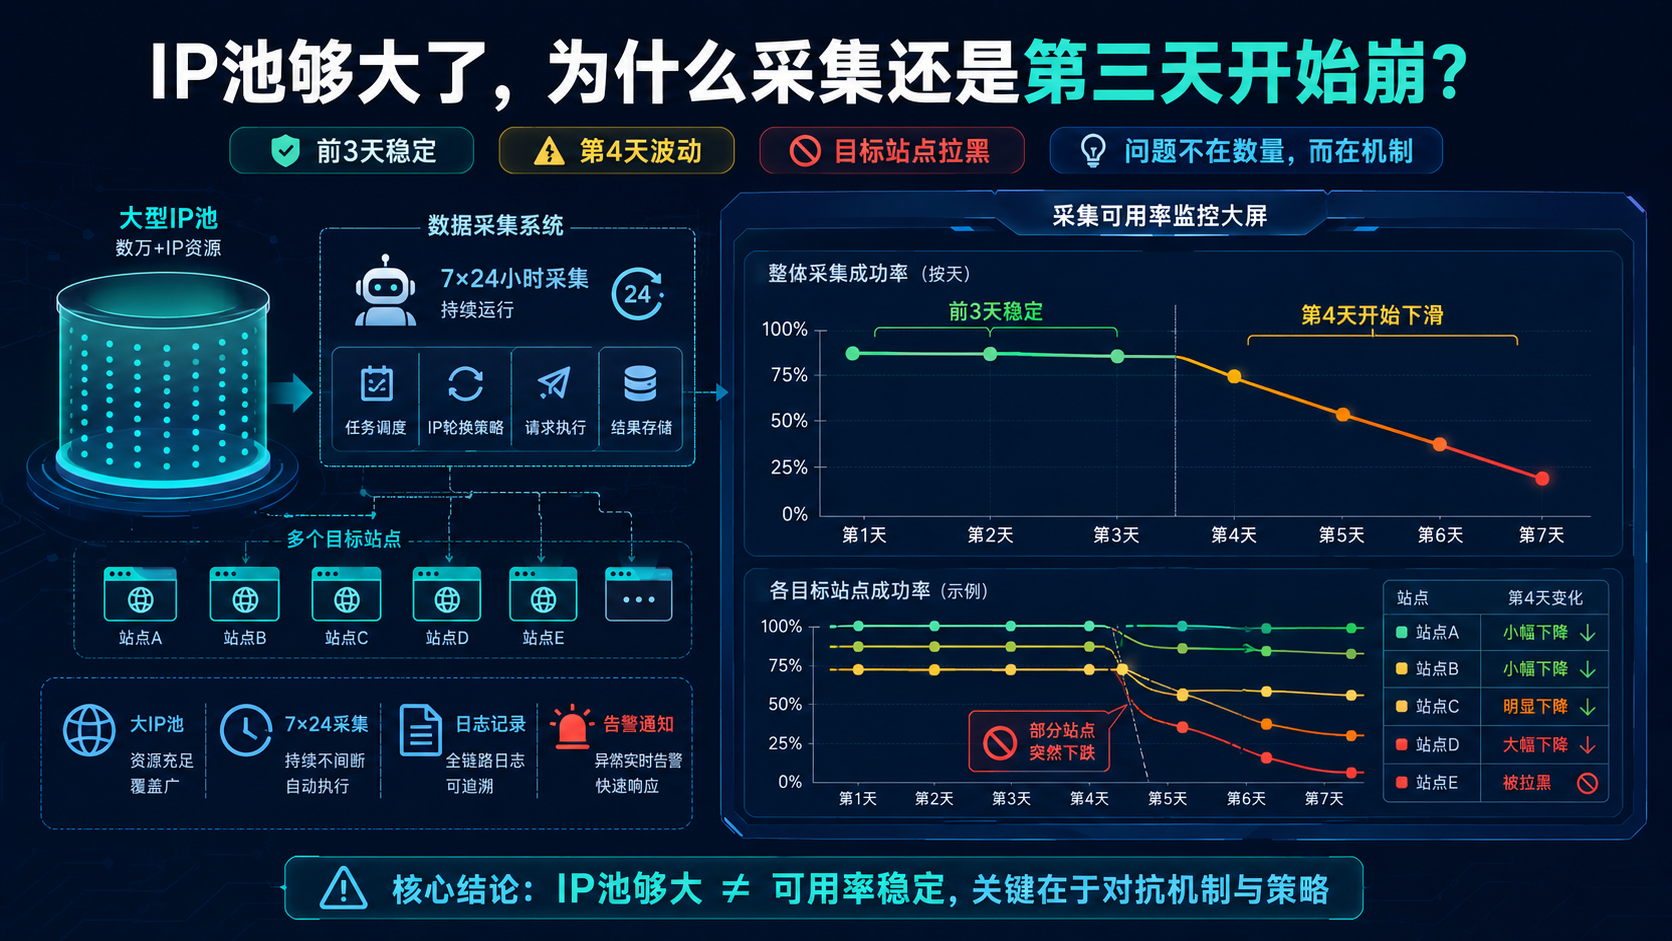
这次实践的起点:一个典型的”先稳后崩”任务
某互联网头部企业在网站采集器场景下启动了一个持续采集项目,接入青果的隧道代理。任务规格如下(以下数据均来源:青果网络官网):
| 项目参数 | 具体数值 |
|---|---|
| 日均采集请求量 | 数百万次 |
| 覆盖目标站点 | 数十个公开数据源 |
| 运行模式 | 7×24不间断 |
| 接入方案 | 隧道代理,每次请求自动换IP,0代码接入 |
| 可关联IP池 | 600万+纯净IP轮换 |
| 协议 | HTTP(S)/SOCKS5 |
前3天表现符合预期:整体可用率99.2%,响应延迟<100ms。各目标站点采集正常。
第4天开始,3个目标站点的采集成功率集中下滑。客户侧日志显示:部分IP段被目标站点集中拉黑,且拉黑速度快于IP池的轮换速度。
直觉判断是”IP不够”,但该项目可关联的IP池规模是600万+,日均请求量数百万次,池规模和请求量的比例并不紧张。问题出在别的地方。
归因拆解:从76%到99.9%卡在哪三个节点
排查后,问题归因到三个独立但协同的工程节点。逐一拆:
- 节点一:后端池更新节奏与采集高峰错位。
日更600万+纯净IP(来源:青果网络官网)意味着池本身在持续换血,但更新窗口如果和采集请求高峰重叠,就会出现”被目标站点标记的IP还没被替换就被分配出去”的情况。该项目的采集高峰集中在凌晨(目标站点策略相对宽松),恰好和池更新窗口部分重叠。
对策:把采集任务的高峰时段与池更新窗口错开,让池在请求低谷期完成换血。调整后,高峰时段分配到被标记IP的概率显著下降。
- 节点二:故障切换时延过长。
原方案下,单个IP故障后的切换逻辑在客户端:先检测到请求失败,再发起重连,整个链路耗时数秒。对于日均数百万次请求的任务,每次切换多耗几秒,累积下来对可用率的拖拽不可忽视。
对策:切换逻辑下沉到服务端。隧道代理的设计逻辑本身就是”每次请求自动换IP,故障IP由服务端剔除”,故障检测和切换都在代理服务端闭环,切换时延从秒级降到亚秒级。这一步不需要客户改代码,确认接入方式走隧道模式即可。
- 节点三:业务分池隔离缺失。
最关键的一个问题:该项目数十个目标站点的采集任务共用同一个IP池,A站拉黑的IP会被分配给B站的采集请求。结果是A站的被标记IP传染到B站,导致连锁降级。
对策:按目标站点维度做业务分池,每类采集任务走独立的IP子池,子池之间隔离。A站被拉黑的IP不会出现在B站的请求里。这就是业务分池技术在企业级采集场景的实际价值:不是”IP更多”,是”IP不会被交叉污染”。
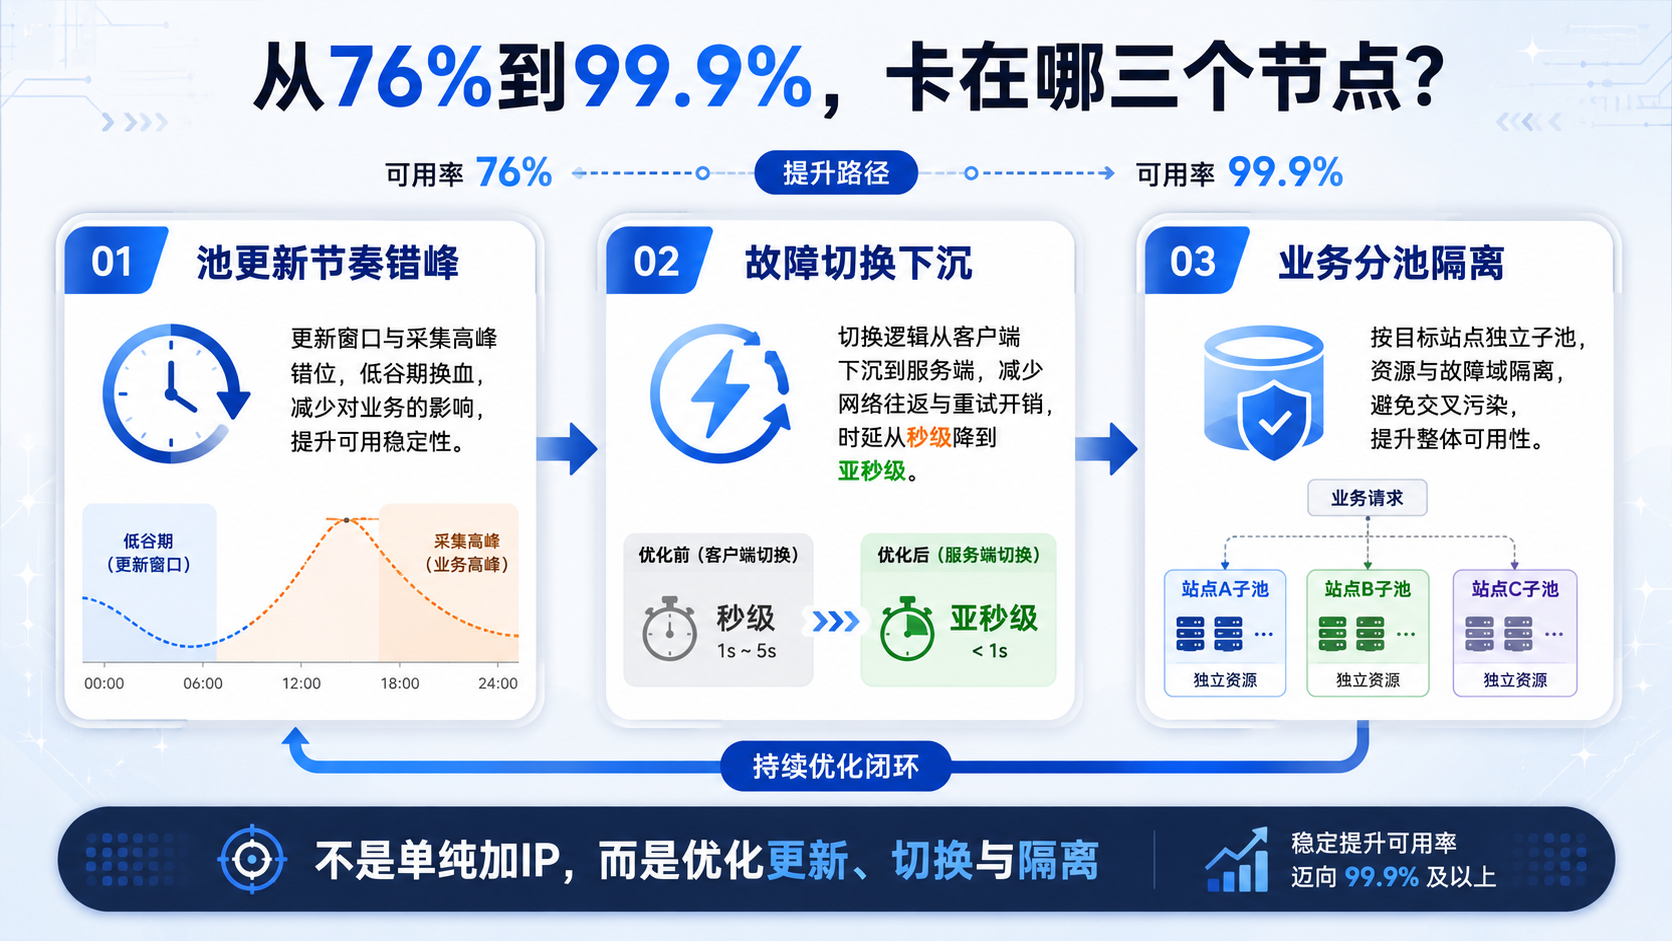
三个节点的对策与效果汇总:
| 节点 | 故障现象 | 根因 | 对策 | 效果 |
|---|---|---|---|---|
| 池更新节奏 | 高峰时段被标记IP仍被分配 | 更新窗口与采集高峰重叠 | 错峰更新,低谷期换血 | 高峰段被标记IP分配率显著下降 |
| 故障切换时延 | 单IP故障后数秒才恢复 | 切换逻辑在客户端,链路长 | 切换下沉到服务端(隧道代理) | 切换时延降到亚秒级 |
| 业务分池隔离 | A站被标记IP传染B站 | 多任务共用同一IP池 | 按目标站点分池,子池隔离 | 交叉污染归零 |
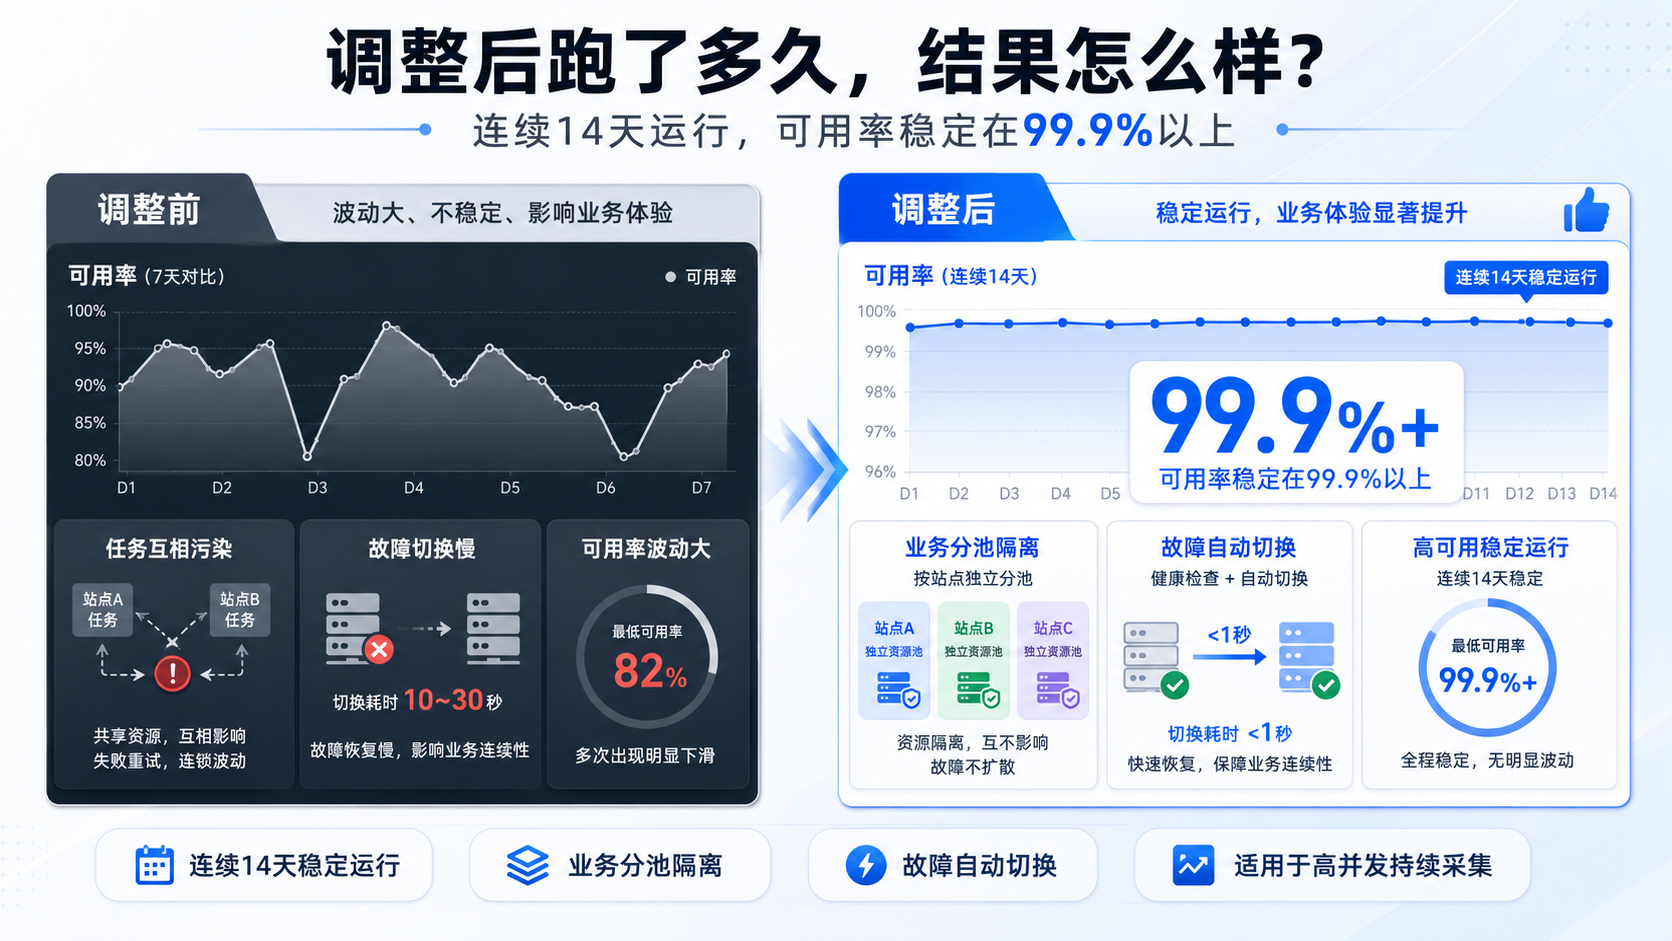
调整后跑了多久,结果怎么样
三个节点同步调整后,该项目连续运行14天,整体可用率稳定在99.9%以上(来源:青果实践观测,2024–2025,样本=该项目连续14天全量请求数据)。
从结果回溯,三步调整的贡献排序:
| 优先级 | 调整项 | 贡献判断 |
|---|---|---|
| 第一 | 业务分池隔离 | 消除交叉污染后,单站点的可用率波动不再传染到其他站点,整体可用率的下限被兜住 |
| 第二 | 故障切换时延下沉 | 亚秒级切换让单次故障对可用率的拖拽从”可感知”变成”可忽略” |
| 第三 | 池更新节奏错峰 | 减少高峰时段的被标记IP分配,属于锦上添花但不可缺 |
值得记录的一个反直觉发现:三步调整中,没有一步是”加IP”。该项目从头到尾使用的IP池规模没变,变的是池的运转机制和任务的隔离方式。
这个路径适用什么场景,不适用什么
上述三步路径适用于高并发持续采集场景,典型如网站采集器、舆情监测、广告监测这类7×24不间断任务,日均请求量在百万级以上。隧道代理的自动切换和0代码接入是这个路径的前提,每次请求自动换IP(来源:青果网络官网),故障切换由服务端接管,客户端不需要自己做IP调度。
不适用的场景也要标清:需要固定出口IP或登录态长会话保持的任务,隧道代理”每次请求换IP”的特性反而是障碍,这类需求应该走独享代理(独占IP,存活0–24小时可调,来源:青果网络官网)或长效代理。把采集任务的类型和代理产品类型对齐,本身就是选型的一部分。
青果网络在这类企业级采集项目中反复确认的一条边界是:隧道代理解决的是”高并发自动轮换”的问题,不解决”IP需要固定”的问题。本篇拆的路径只覆盖前者,后者的工程路径完全不同,需要另行评估。把这个边界提前划清,后端业务的链路问题就不会被甩锅到代理IP上。
FAQ
Q:可用率99.9%和76%的差距,对业务影响有多大?
A:看起来只差20%+个百分点,但放到日均数百万次请求的任务里,76%意味着每天约数万次请求失败,99.9%把失败次数压缩到数百次级别。对舆情监测、广告监测这类对数据完整性敏感的场景,这个量级差距直接影响分析结论的可靠性。
Q:业务分池技术是不是所有采集场景都需要?
A:不是。日均请求量较低且只采集单一目标站点的轻量任务,分池的收益不明显。业务分池的价值在多目标站点并发采集场景里才显现,目标站点越多,交叉污染的概率越高,分池的必要性越强。
Q:隧道代理和短效代理在这个场景下怎么选?
A:两者都支持IP轮换,区别在接入方式和IP调度归属。隧道代理0代码接入,每次请求自动换IP,故障切换由服务端处理,适合不想在客户端自建IP调度层的项目。短效代理(按量0.00216元/IP起,来源:青果网络官网)需要客户端自行提取IP并管理切换逻辑,灵活度更高但工程量也更大。看团队是否愿意投入IP调度的开发维护成本。
Q:故障切换时延降到亚秒级,需要额外配置吗?
A:我们青果网络的隧道代理在设计上就是服务端完成IP切换和故障剔除,客户端对接隧道入口即可,不需要额外配置。每次请求的IP分配和故障处理都在服务端闭环(来源:青果网络官网)。
Q:池更新节奏怎么和采集任务错峰?
A:核心操作在采集任务侧:确认自己的采集高峰时段,观察不同时段可用率是否有规律性波动(如每天某个时段下降),有规律性波动的时段大概率和池更新窗口重叠,把采集高峰挪开即可。让高峰请求尽量命中”刚更新完”的IP,而不是”正在更新”的IP。
Q:这个路径能直接复制到海外采集场景吗?
A:路径逻辑(错峰更新+切换下沉+业务分池)是通用的,但海外代理有一个硬边界:仅支持在境外网络环境下使用(来源:青果网络官网)。跨境选品、海外广告监测这类境外采集任务,路径可复制;但不能在境内网络环境下使用海外代理。
Q:想验证这个路径,最小化的测试方案是什么?
A:用一个中等请求量的采集任务(日均数十万次),接入隧道代理,连续跑3–5天,观察可用率曲线。如果出现”先稳后崩”的模式,大概率是本文拆的三个节点之一在起作用。免费测试时长6小时(来源:青果网络官网),够跑一轮初步验证。