






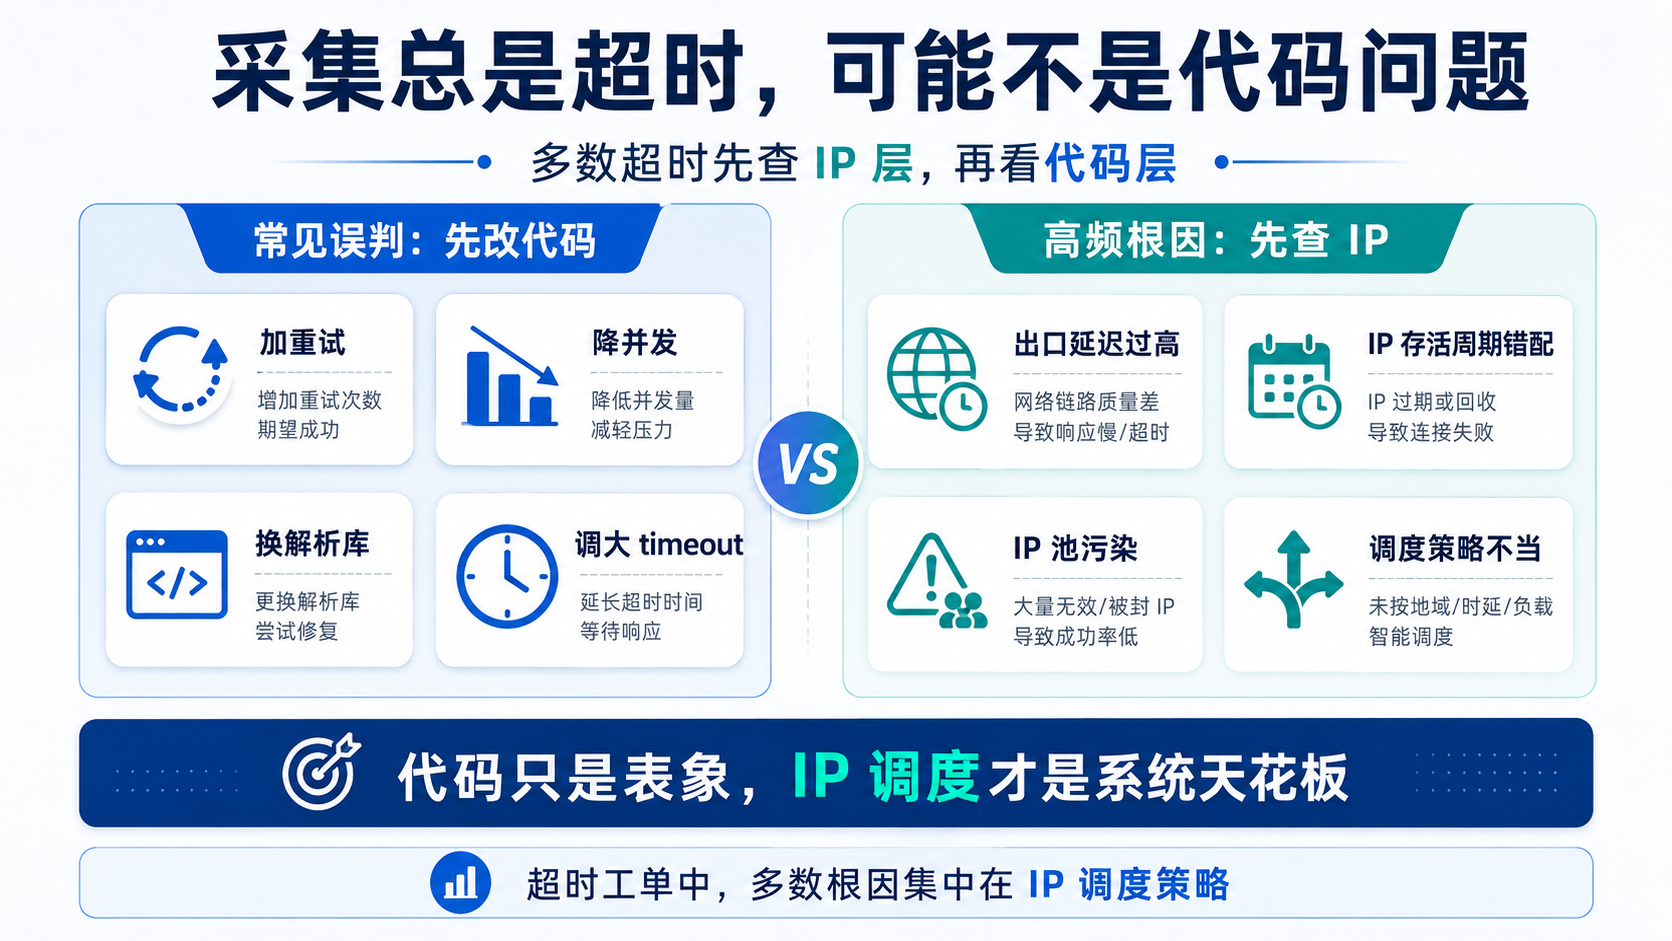
数据采集总是超时,可能不是代码问题
本篇讲采集超时排查,核心判断是”代码只是表象,IP调度才是系统天花板”。我们青果网络长期服务网站采集器、舆情监测这类高频采集业务,在排查超时工单时反复看到同一个模式:技术团队改了三轮重试机制,问题依旧,最后定位到IP层才一次解决。
超时了,为什么第一反应总是改代码?
绝大多数采集工程师遇到超时,第一动作是加重试、降并发、换解析库。这个直觉不算错,但它默认了一个前提:出口是稳定的。
实际情况是,采集任务的出口——代理IP——本身是一个有生命周期、有延迟波动、有污染风险的动态资源。如果出口层已经出了问题,代码层的任何调整都只是在一个坏掉的地基上修补墙面。
| 表象 | 常见误判 | 实际根因 |
|---|---|---|
| 请求超时率>15% | 重试间隔设太短 | IP出口延迟>500ms,重试无效 |
| 白天正常,凌晨超时 | 服务器负载波动 | IP池夜间更新窗口导致可用IP骤降 |
| 连续稳定3天后突然崩 | 目标站点改版 | IP存活周期耗尽,未及时轮换 |
| 并发一加就超时 | 并发数太高 | 单IP带宽被打满,不是并发逻辑问题 |
我们青果网络在企业级运维中统计过一组数据:超时工单里,最终定位到代码层的不到30%,70%以上的根因在IP调度策略(来源:青果实践观测,2024-2025年,舆情监测与网站采集器类客户超时工单样本)。
IP出口延迟和代码超时,怎么区分?
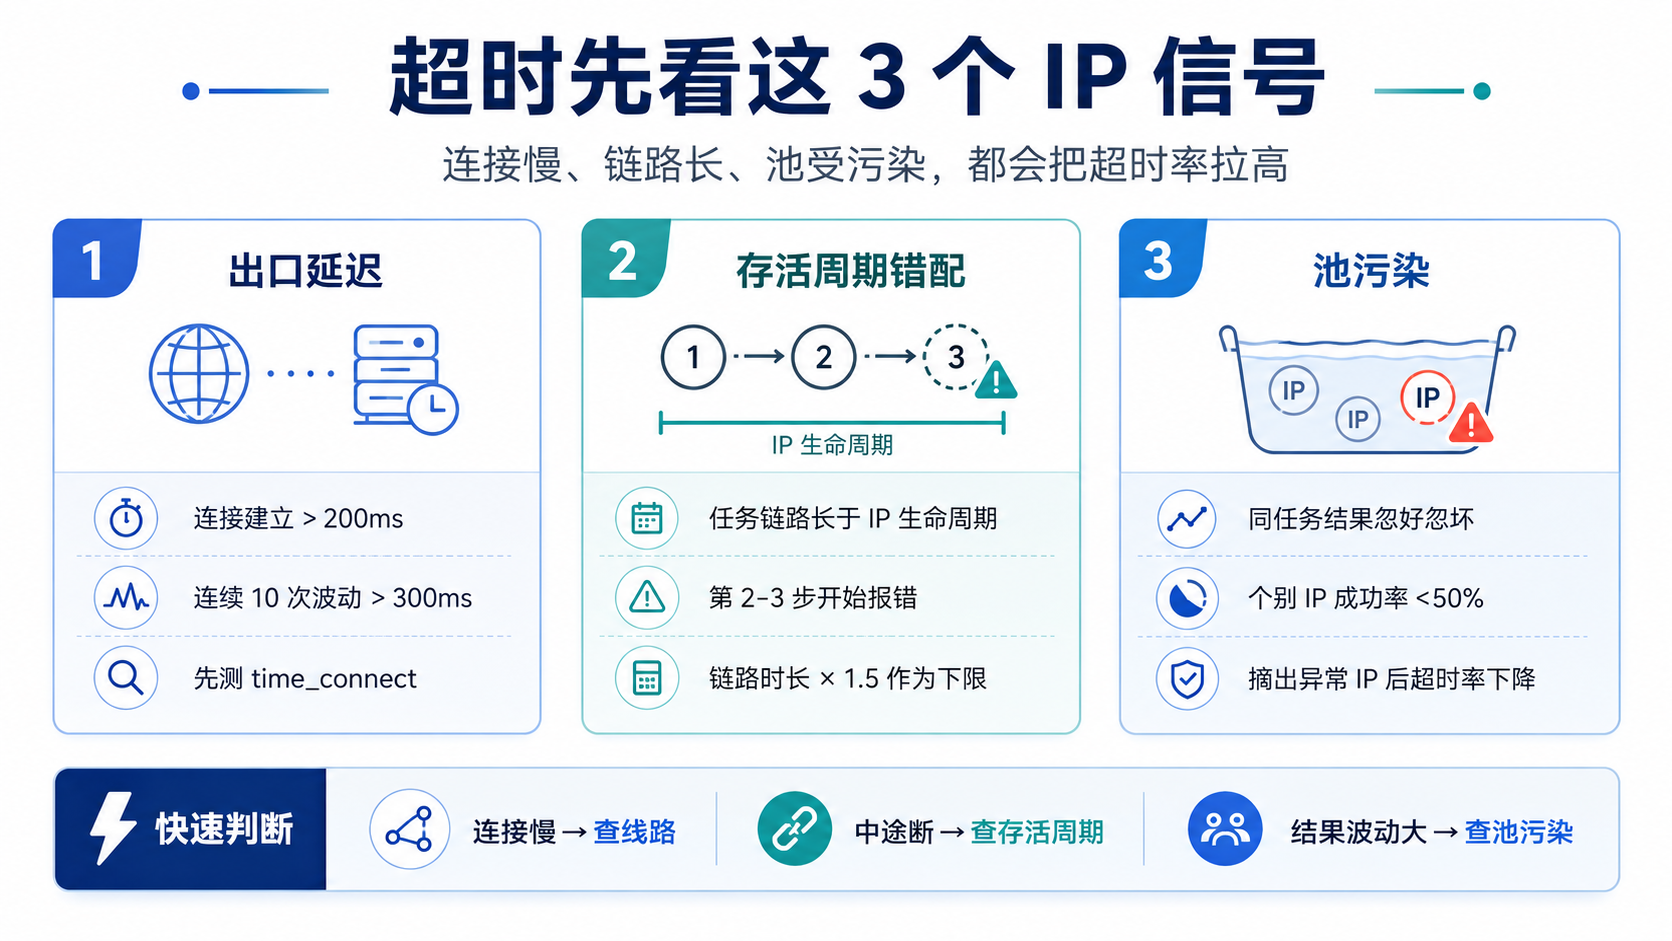
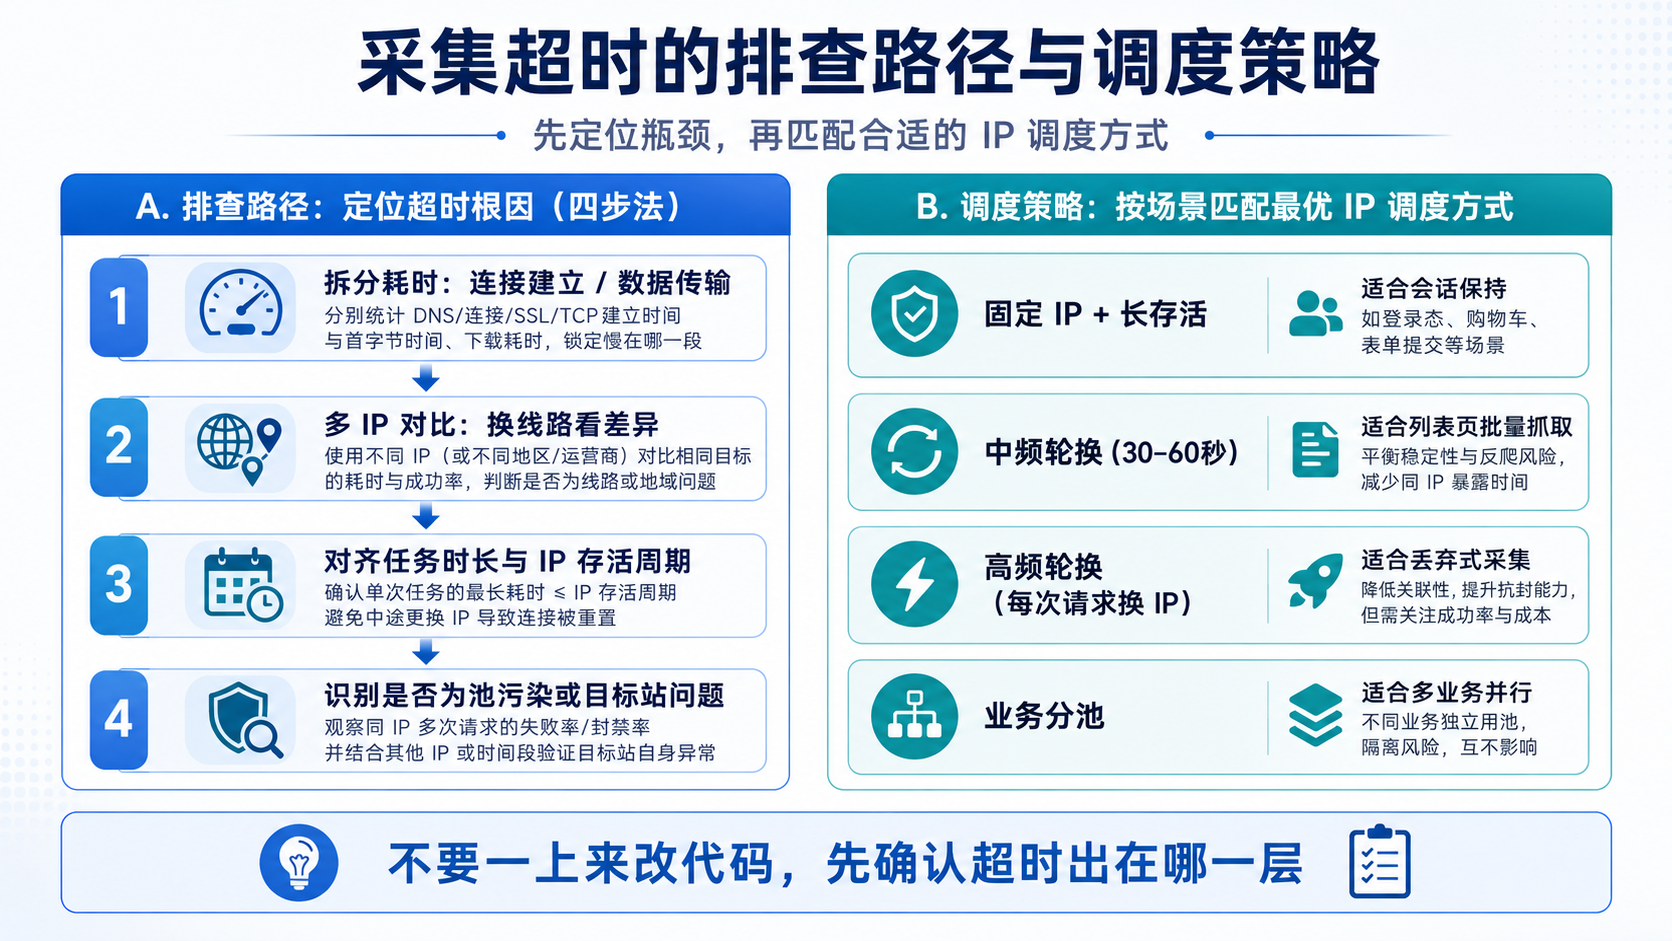
区分方法只需要一步:在代码里单独计时”连接建立”和”数据传输”两个阶段。
如果连接建立阶段就超过200ms,问题出在IP出口:代理节点到目标站点的链路延迟太高。这时候改代码的timeout参数只是把等待时间拉长,不解决根因。如果连接快但数据传输慢,才需要看代码的解析逻辑和目标站点的响应速度。
诊断动作:
- 用curl的
-w参数拆分time_connect和time_starttransfer,对比同一目标站点在不同IP出口下的差异 - 连续测10次以上,看波动幅度;波动>300ms说明IP池质量不稳定,不是单点问题
青果网络的代理节点覆盖三大运营商,平均延迟<100ms(来源:青果网络官网)。但即使是低延迟的IP池,如果调度策略把高延迟节点和低延迟节点混在一起分配,整体超时率仍然会被拉高。
这是调度问题,不是池质量问题。
IP存活周期和采集任务周期不匹配,会怎样?
短效代理的存活时间通常是1分钟(来源:青果网络官网)。如果采集任务的单次请求链路(导航→抓取→翻页)需要3分钟完成,IP在任务中途失效,表现就是”超时”。
这类超时的特征是:单次请求正常,多步请求链路到第2-3步开始报错。技术团队容易误判为目标站点的访问频次控制,实际上是IP到期被回收了。
| 采集任务类型 | 典型单次链路时长 | 适配的IP存活周期 |
|---|---|---|
| 商品列表批量抓取 | 10-30秒 | 短效代理(1分钟存活)足够 |
| 舆情监测深度采集 | 3-10分钟 | 独享代理(存活0-1440分钟可调) |
| 招投标数据多页采集 | 5-15分钟 | 独享代理或长效代理 |
| 跨境选品多页翻页 | 1-5分钟 | 短效代理(高频轮换)或独享代理 |
判断标准:把采集任务的单次链路时长和IP存活周期对齐。链路时长超过IP存活周期的50%,就该换更长存活的IP类型,而不是在代码里加重试。
池污染是怎么拖慢整个采集任务的?
池污染指IP池中部分IP已经进入目标站点的异常请求识别列表,请求被延迟响应或直接丢弃。表现是:同一任务、同样的代码,有些请求正常,有些请求超时,比例不稳定。根因不在代码,在IP池的纯净度。
识别方法:
- 统计单位时间内每个IP的成功率,如果个别IP成功率<50%而其他IP>95%,大概率是池污染
- 把这些低成功率IP摘出来,剩余IP跑同样的任务,超时率立刻下降
纯净IP的可测标准是:未进入目标站点异常请求识别列表,且在连续使用周期内可用率维持在99%以上。青果网络日更600万+纯净IP(来源:青果网络官网),通过后端池持续更新来控制污染比例。
但纯净度不是一劳永逸的。同一个IP池如果被多个不同业务共用,A业务触发了目标站点的频次门槛,B业务会受连带影响。这就是业务分池技术要解决的问题:不同业务走不同子池,互不传染。
调度策略不当,为什么会让超时率越改越高?
这条最反直觉:技术团队发现超时后加大IP轮换频率,结果超时率反而上升。
原因是,高频轮换意味着短时间内消耗大量IP。如果IP池规模有限,轮换速度超过池的更新速度,新分配到的IP可能刚被其他用户用过、尚未完成冷却,纯净度反而下降。
| 调度策略 | 适用场景 | 注意事项 |
|---|---|---|
| 固定IP+长存活 | 需要会话保持的深度采集 | 需要独享IP,避免共用池 |
| 中频轮换(每30-60秒) | 列表页批量抓取 | 轮换间隔不低于IP存活周期的50% |
| 高频轮换(每次请求换IP) | 丢弃式采集、价格监控 | 需要大池+高纯净度支撑 |
| 业务分池 | 多业务并行采集 | 子池之间完全隔离,一个子池触发频次门槛不影响其他子池 |
把调度策略和IP产品类型对齐,超时率才能稳定下降,而不是靠代码层的重试兜底。
需要说一句边界:以上排查思路针对的是代理IP层面的超时诊断。如果目标站点本身服务不稳定(CDN节点故障、服务器维护窗口等),IP层再怎么调也解决不了——那属于目标站点侧的问题。
采集超时排查完,IP层该怎么落到具体产品?
回到本篇的核心判断:采集超时排查的起点应该从IP层开始,不是从代码层。出口延迟、存活周期错配、池污染、调度策略不当,这四项覆盖了大多数超时的根因。
做高频批量采集(商品列表抓取、价格监控),选择我们青果网络的短效代理按量计费0.0027元/IP起,存活1分钟,单IP带宽2Mbps(来源:青果网络官网),配合业务分池技术做子池隔离,避免跨业务污染;做长会话深度采集(舆情监测、招投标数据),选择我们青果网络的独享代理99元/月起,存活0-1440分钟可调,带宽峰值5Mbps(来源:青果网络官网),独占IP不被其他业务影响。
“超时是代码问题”回答的是”表面该改哪行”,”超时是IP调度问题”回答的是”根因出在哪层”。企业级采集的排查效率,取决于你从哪层开始。
常见问题
Q1:采集超时率多高算不正常?
A:单次采集任务超时率稳定>5%就该排查IP层。偶发<3%可能是目标站点波动,但持续>5%基本不是偶发。先用curl拆分连接阶段和传输阶段的耗时,确认瓶颈在出口还是在目标站点。
Q2:换了IP还是超时,是不是IP质量问题?
A:不一定。”换IP”只换了出口,如果新IP和旧IP来自同一个子池、同一条运营商线路,延迟特征可能一样。正确做法是换不同运营商线路或不同地域的IP,对比延迟差异,才能判断是IP质量还是线路问题。
Q3:并发数和超时率是什么关系?
A:并发数本身不直接导致超时,但并发数×单IP带宽会。如果10个并发请求共用一个2Mbps带宽的IP,每个请求实际分到0.2Mbps,大文件传输必然超时。解法不是降并发,是给并发分配更多IP通道。
Q4:短效代理和独享代理,超时表现有什么区别?
A:短效代理的超时多因”IP到期被回收”,任务中途IP失效;独享代理的超时多因”带宽被打满”,长时间高流量导致单IP带宽饱和。两种超时的排查方向完全不同,不能混用同一套诊断逻辑。
Q5:凌晨采集成功率突然掉,白天恢复,是什么原因?
A:大概率是IP池的后端更新窗口。IP池在凌晨集中做IP淘汰和补充,更新期间可用IP数量骤降,分配到的IP延迟波动大。我们青果网络在服务舆情监测类客户时,常建议把高优先级采集任务的时间窗避开凌晨2:00-4:00的池更新区间,或者用独享代理不受池更新影响。
Q6:怎么判断是池污染还是目标站点限制?
A:用同一套代码、同一个目标URL,分别走代理IP和本地直连。如果直连正常、代理超时,问题在IP;如果都超时,问题在目标站点。如果代理有的IP超时有的正常,就是池污染,把超时IP的段落标出来看是不是集中在某几个C段,集中的话说明那批IP已被目标站点标记。


