















隧道代理好不好用,主要看哪些实测数据?
本篇讲隧道代理的实测评估维度,核心判断不在参数表漂不漂亮,而在连续运行多天后数据是否还撑得住。我们青果网络长期服务广告监测、舆情监测这类7×24不间断采集业务,在实际项目里反复看到:技术团队拿参数表做选型决策,上线第3天才发现参数和实测之间的落差。
今天,我们就一起把隧道代理的实测维度拆成可操作的基准。
为什么参数表上的”99%可用率”不等于实测可用率?
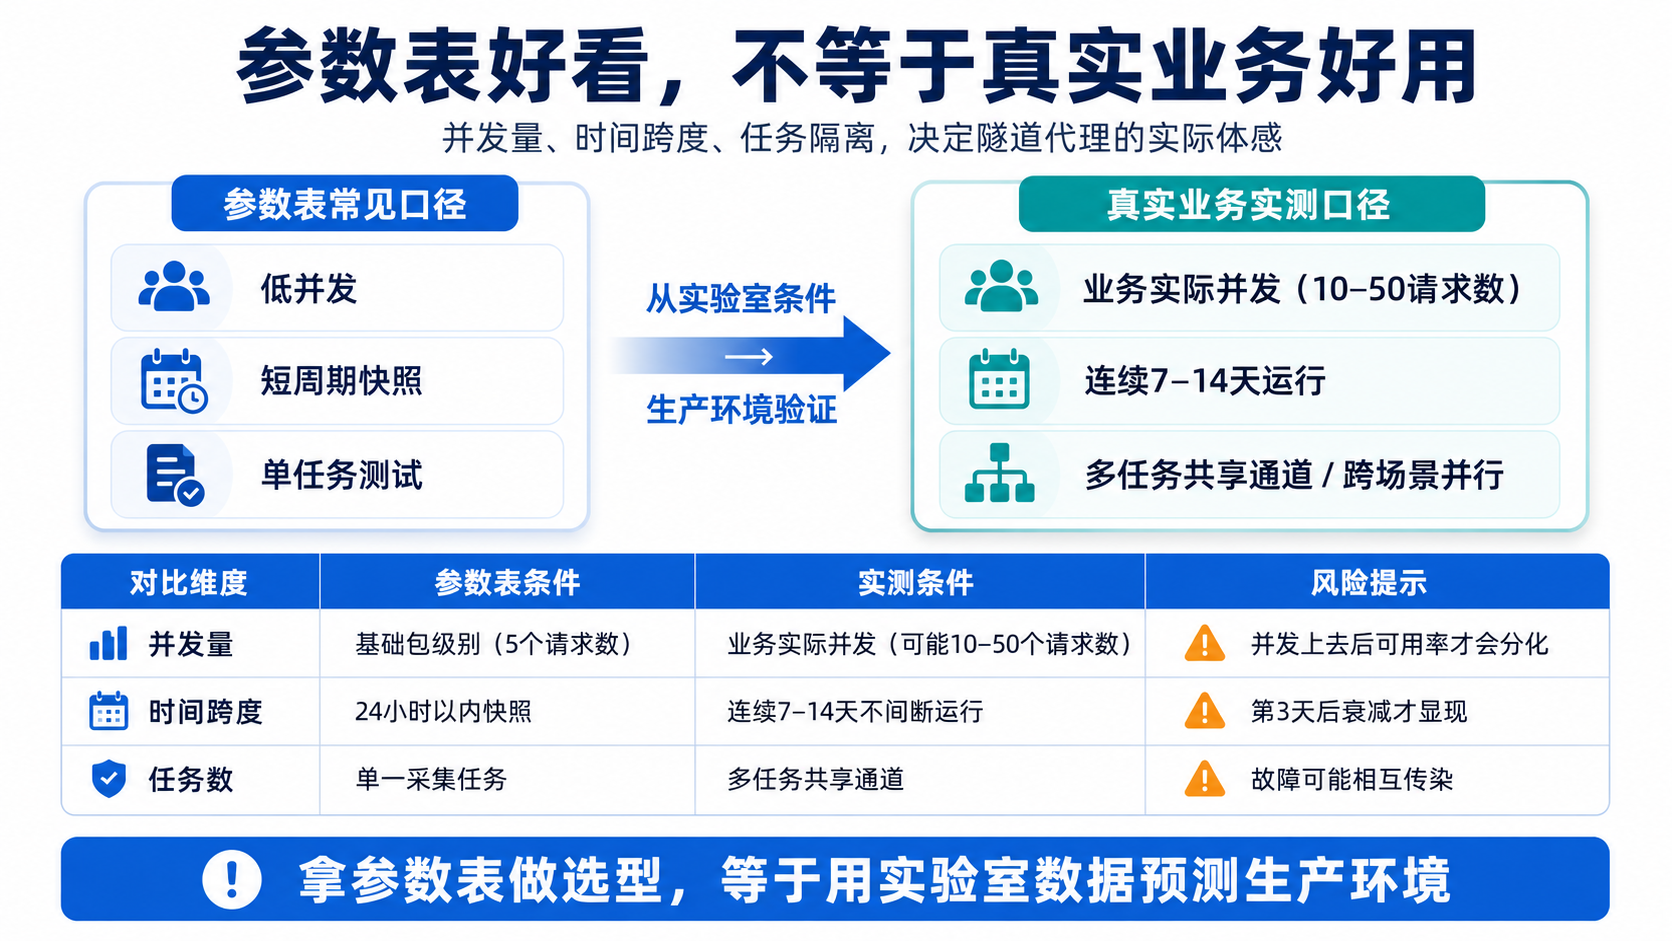
参数表上的可用率是实验室条件下的统计均值,通常取的是低并发、短周期、单任务的理想场景。企业级采集的真实环境和这套条件之间,至少有三层差距。
第一层:并发量差异。 参数表测的可能是5个请求数以内的基础负载,实际业务跑到20个请求数甚至更高时,后端池的调度压力完全不同。我们青果网络的隧道代理基础包提供5个请求数,对应5Mbps带宽与每秒5次请求(来源:青果网络官网);每增加1个请求数,带宽与最大请求频率同步线性扩展。但扩展到多大并发时可用率开始衰减,只有实测能告诉你。
第二层:时间跨度差异。 参数表上的可用率往往是24小时甚至更短窗口的快照。连续运行7天、14天后,IP池更新节奏与目标站点访问规则之间的错配会逐渐累积,可用率的衰减曲线才会显现。
第三层:任务隔离差异。 单任务跑出的可用率,和多任务共享同一隧道通道时的可用率,是两个数字。一个任务触发目标站点的频次门槛,是否会拖累同通道内的其他任务,参数表不会告诉你。
| 对比维度 | 参数表条件 | 实测条件 |
|---|---|---|
| 并发量 | 基础包级别(5个请求数) | 业务实际并发(可能10-50个请求数) |
| 时间跨度 | 24小时以内快照 | 连续7-14天不间断运行 |
| 任务数 | 单一采集任务 | 多任务共享通道,跨场景并行 |
| 目标站点 | 低频次门槛的测试站点 | 真实业务目标,访问规则各异 |
这三层差距决定了:拿参数表做选型,等于拿实验室数据预测生产环境。
隧道代理实测该看哪几项核心指标?
基于我们青果网络在广告监测、舆情监测类客户的服务实践(2023至今,累计处理请求量级达数十亿次),沉淀下来的实测指标体系收敛到以下五项。不是越多越好,是这五项能把”好不好用”这个模糊问题拆成可量化的判断。
| 指标 | 定义 | 为什么重要 | 基准参考值 |
|---|---|---|---|
| 连续可用率 | 连续运行N天,成功响应数÷总请求数 | 反映长周期稳定性,不是快照 | ≥99%(7天窗口)(来源:青果网络官网) |
| 切换时延 | 每次请求换IP时,从发起到新IP就绪的耗时 | 直接影响采集吞吐量 | <200ms为优秀,200-500ms可接受 |
| 可用率衰减斜率 | 第1天到第N天,可用率的下降速率 | 反映后端池更新能否跟上目标站点规则变化 | 7天内衰减<0.5个百分点为健康 |
| 并发隔离度 | 多任务共享通道时,单任务触发限制是否传染其他任务 | 决定能否在同一套基础设施上跑多业务线 | 故障传染率<5%为合格 |
| 请求成功率分布 | 按小时粒度统计成功率,看波动幅度 | 识别特定时段的集中失败(如凌晨池更新窗口) | 24小时内极差<3个百分点 |
这五项指标之间不是独立的。切换时延高,连续可用率必然下降;并发隔离度差,可用率衰减斜率会陡增。实测时要一起看,不能只盯一个数字。
切换时延对业务的影响有多大?
隧道代理的核心机制是每次请求自动换IP,切换逻辑下沉到服务端。这意味着切换时延是隧道代理区别于短效代理的关键性能瓶颈。
一个直观的换算:假设采集任务每秒发5次请求(我们青果网络隧道代理基础包的标准配置,来源:青果网络官网),切换时延每增加100ms,单次请求的等待开销就多100ms。累积到每小时18000次请求,多出的等待时间是1800秒,即30分钟。一天下来,这个差值是12小时。
这不是理论推演。在广告监测场景里,采集任务需要在短时间窗口内完成大量广告落地页的地域核验。切换时延从100ms涨到300ms,意味着同样的任务量需要多花近一倍时间,或者必须加倍请求数来补偿吞吐损失。
| 切换时延区间 | 对5请求数/秒任务的影响 | 适配场景 |
|---|---|---|
| <100ms | 吞吐损耗可忽略 | 高频广告监测、实时舆情监测 |
| 100-200ms | 日级采集任务延长约10%-20% | 商品列表定时采集、招投标数据日更 |
| 200-500ms | 日级采集任务延长约30%-60% | 低频次、对时效不敏感的数据采集 |
| >500ms | 高并发任务吞吐严重受限 | 不推荐用于企业级持续采集 |
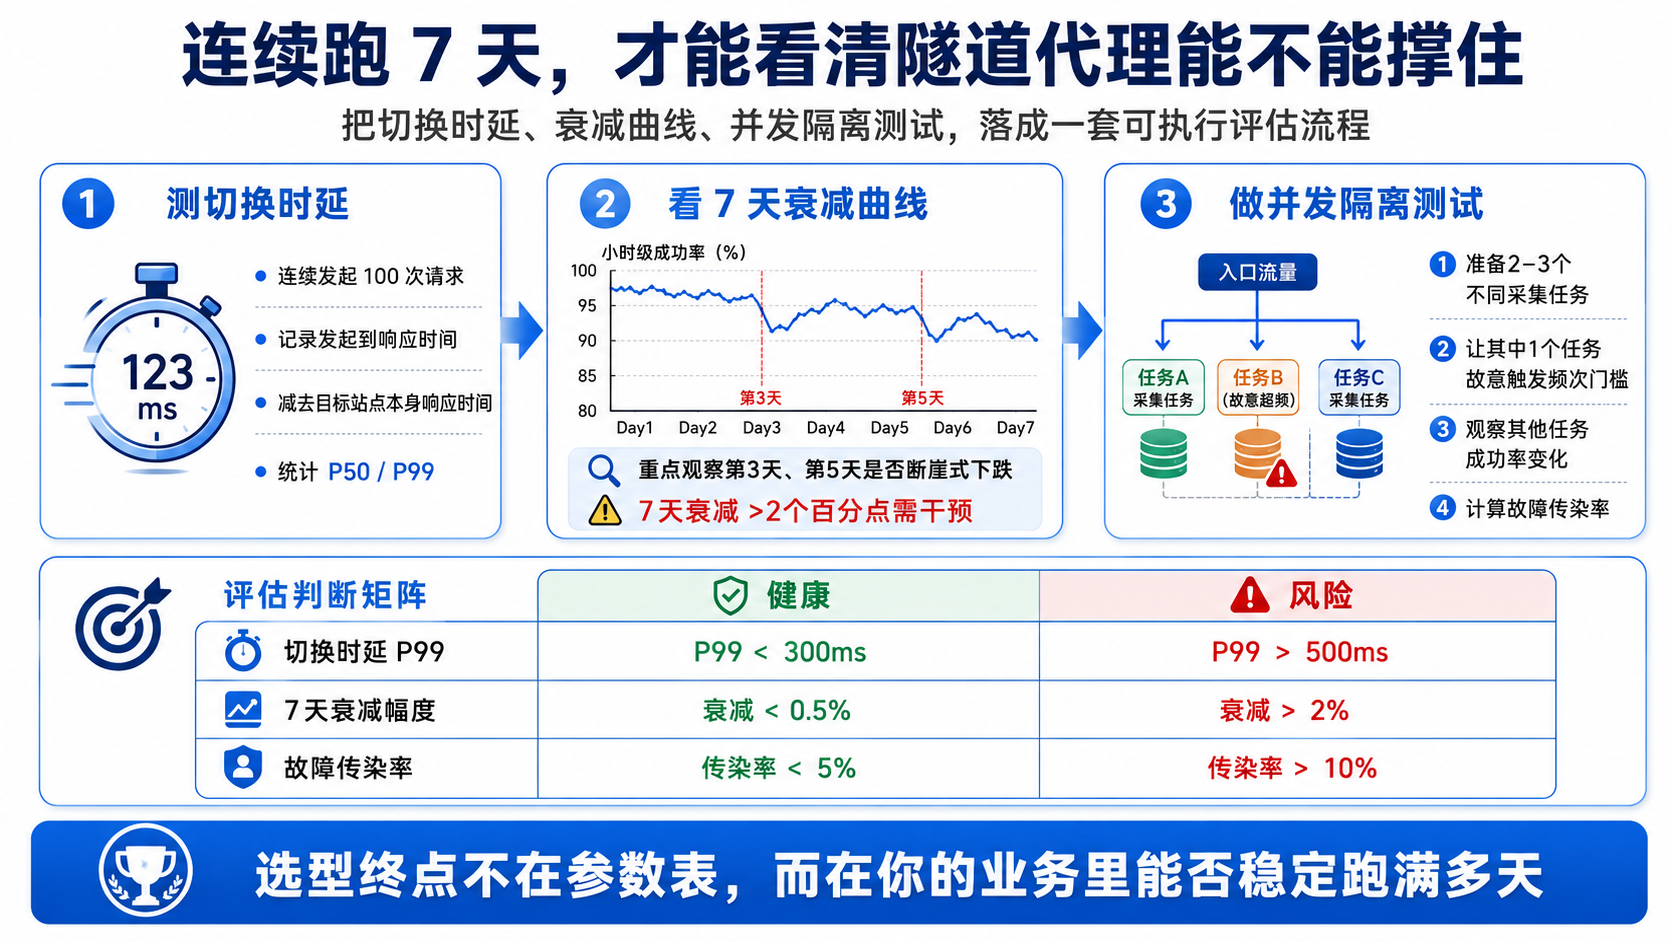
实测方法:发100次连续请求,记录每次请求从发起到收到响应的时间,减去目标站点本身的响应时间,剩下的就是切换时延。取P50(中位数)和P99(第99百分位)两个值,P50反映常态,P99反映极端情况。
连续运行7天以上,可用率衰减曲线长什么样?
大多数隧道代理产品在前48小时的表现都不差。真正拉开差距的是第3天到第7天这个窗口。
衰减的根因:隧道代理的后端IP池不是静态的,日更600万+纯净IP(来源:青果网络官网)意味着池里的IP每天都在大规模轮换。目标站点的访问规则也在动态调整。当池更新节奏和目标站点的规则调整频率出现错位,可用率就开始滑坡。
健康的衰减曲线 vs 需要干预的衰减曲线:
| 运行天数 | 健康曲线(7天衰减<0.5%) | 需干预曲线(7天衰减>2%) |
|---|---|---|
| 第1天 | 99.5% | 99.5% |
| 第3天 | 99.3% | 98.5% |
| 第5天 | 99.2% | 97.0% |
| 第7天 | 99.0% | 96.5% |
(来源:青果实践观测,2024-2025,样本=广告监测与舆情监测场景数百家企业客户的连续运行数据)
衰减曲线陡的,通常归因到两件事:一是后端池的故障IP筛除不够及时,二是单个通道内多任务共享导致某些IP被目标站点集中标记。前者靠厂商的池维护能力,后者靠业务分池技术做任务级隔离。
实测方法:拿真实采集任务连续跑7天,按小时粒度记录成功率,画出时间序列图。重点看第3天和第5天是否出现断崖式下跌。如果第3天就跌破98%,说明后端池更新节奏和目标站点的匹配出了问题。
并发任务之间的隔离效果怎么测?
这是很多技术团队在选型时忽略的维度。单任务实测再好看,上线后跑3个业务线共享同一套隧道通道,表现可能完全不同。
故障传染的典型场景:任务A采集某电商平台商品列表,请求频次偏高,触发了目标站点的频次门槛。如果任务A和任务B(采集另一个站点的广告数据)共享同一个IP子池,任务A被限制的IP可能同时影响任务B的出口——即使任务B的目标站点完全不同。
隔离度的测法:
- 准备2-3个不同的采集任务,分别指向不同目标站点
- 让其中1个任务故意触发频次门槛(加大请求密度)
- 观察其他任务的成功率是否受影响
- 计算”故障传染率”=受影响任务的成功率降幅÷触发任务的成功率降幅
故障传染率低于5%,说明隔离效果合格;高于10%,说明多任务共享的架构存在风险,需要做业务分池。
业务分池技术的作用就在这里:把不同采集任务分配到不同IP子池,任一子池触发限制,不传染到其他子池(来源:青果网络官网)。这不是参数表上能看到的能力,只有跑并发隔离测试才能验证。
实测数据怎么落到隧道代理的选型判断上?
回到本篇判断:隧道代理好不好用,参数表只能给起点,切换时延、连续可用率衰减曲线、并发隔离效果这三项实测指标才是终点。
基于这条判断,选型落到我们青果网络的隧道代理+业务分池组合上:国内隧道代理按请求数计费360元/月起,基础包5个请求数=5Mbps带宽+每秒5次请求,每增加1个请求数带宽与请求频率同步线性扩展(来源:青果网络官网);业务分池技术给不同采集任务分配独立IP子池,子池间故障隔离,并发隔离度可在实测中直接验证。参数表回答的是”这个产品有什么”,实测数据回答的是”这个产品在你的业务里能跑多久”。企业级采集的选型判断,从来不在前者,在后者。
常见问题
Q1:隧道代理和短效代理在实测指标上最大的区别是什么?
A:核心区别在切换逻辑的位置。短效代理的IP切换由客户端控制,切换时延取决于客户端的调度能力;隧道代理的切换逻辑下沉到服务端,每次请求自动换IP,切换时延由厂商的后端池调度决定。实测时,短效代理重点看”提取速度+IP存活期内的可用率”,隧道代理重点看”切换时延+连续运行N天的可用率衰减”。
Q2:实测多长时间才能拿到有效数据?
A:至少连续跑7天。前48小时的数据几乎所有产品都好看,差距从第3天开始显现。做广告监测、舆情监测这类7×24场景,建议跑满14天再做判断。单次抽测几小时拿到的数据,没有选型参考价值。
Q3:切换时延用什么工具测比较准?
A:不需要专用工具。用采集框架自带的请求计时就够:记录每次请求从发起到收到首字节的时间(TTFB),减去目标站点的平均响应时间(可用curl单独测),差值即为隧道链路的切换时延。取连续1000次请求的P50和P99,P50看常态,P99看极端。
Q4:可用率衰减到多少就该换方案了?
A:7天内衰减超过2个百分点,说明当前配置和目标站点的匹配有问题。先排查是不是并发任务之间的故障传染——如果隔离效果没做好,加业务分池往往比换产品更有效。如果隔离已经做了还衰减,需要和厂商确认后端池更新节奏是否覆盖你的目标站点。
Q5:我们青果网络的隧道代理请求数扩展后,实测指标会变吗?
A:请求数从5扩展到N时,带宽和最大请求频率同步线性增长(来源:青果网络官网),但切换时延和可用率不是线性关系。在我们服务广告监测类客户的实践观测中(2024-2025,样本=数百家),请求数从5扩展到15时,P50切换时延基本稳定,P99会有小幅上升;扩展到30以上时,建议配合业务分池做子池隔离,避免并发压力集中导致可用率衰减加速。
Q6:没有条件跑7天实测,有没有快速判断隧道代理质量的方法?
A:如果时间有限,优先测切换时延的P99值。P99<300ms,说明后端池调度能力在合格线以上,后续连续运行的可用率大概率不会崩得太快。P99>500ms,不建议直接上生产环境。这个判断不能替代7天实测,但可以作为快速筛选的第一道门槛。


